长上下文推理越跑越贵?On-Demand Attention 让模型「需要时才回看历史」
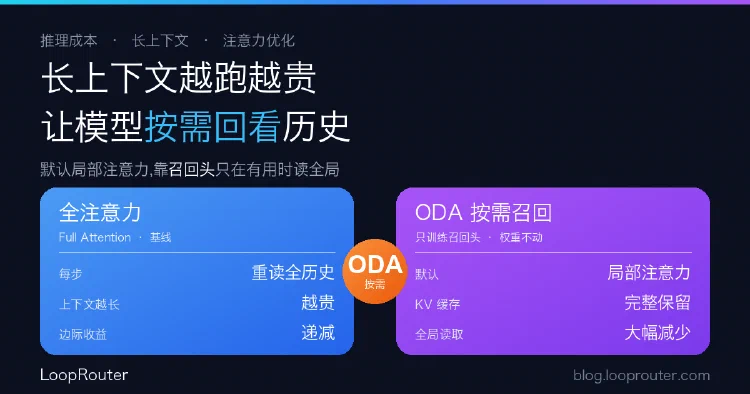
长上下文和 Agent 推理贵,根因之一是全注意力每生成一个 token 都要重读不断变长的历史。arXiv 新论文 On-Demand Attention(ODA)默认用局部注意力,靠一个轻量『召回头』预测『这一步要不要回看全局』,只在有用时才触发全局读取。从接入方视角看,它是同档模型下不同供应商『每 token 成本/延迟』会拉开差距的隐性变量。
按时间浏览全部文档。
长上下文和 Agent 推理贵,根因之一是全注意力每生成一个 token 都要重读不断变长的历史。arXiv 新论文 On-Demand Attention(ODA)默认用局部注意力,靠一个轻量『召回头』预测『这一步要不要回看全局』,只在有用时才触发全局读取。从接入方视角看,它是同档模型下不同供应商『每 token 成本/延迟』会拉开差距的隐性变量。
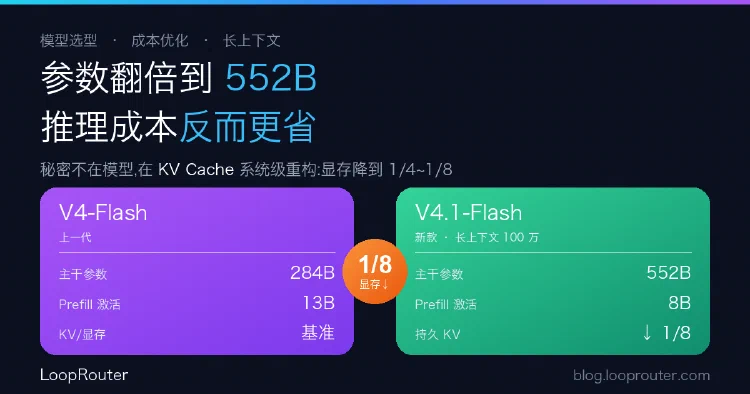
DeepSeek V4.1-Flash 主干参数从 284B 涨到 552B,推理成本却不升反降。关键在于对 KV Cache 的系统级重构:CED 架构、跨层共享 KV、FP4 量化,把百万 Token 场景下的显存降到上一代的 1/4 到 1/8。本文拆解方法与数据,并从模型选型角度分析:为什么长上下文 Agent 的真实成本不能只看每 Token 单价。