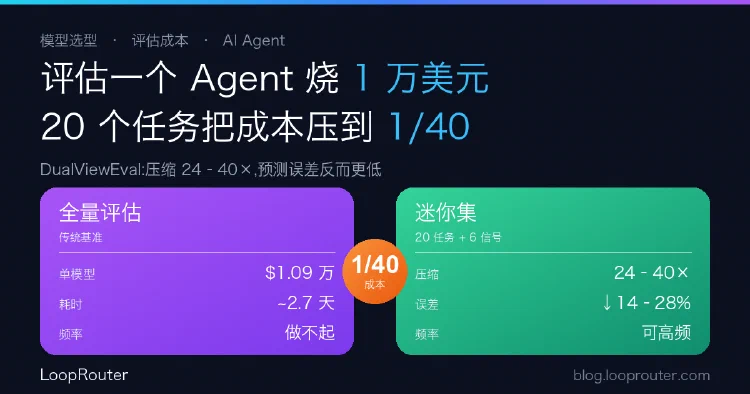
评估一个 Agent 模型要烧 1 万美元、跑 2.7 天:20 个任务的迷你集把选型成本压到 1/40
在 APEX-Agents 上评估一个前沿模型约花 1.09 万美元、跑 2.7 天,让'持续选型'贵到做不起。DualViewEval 用 20 个任务的迷你集加 6 个过程信号,把 Agent 评估压缩 24–40 倍、误差还更低。本文拆解方法,并给出 LoopRouter 的选型与路由落地视角。
按时间浏览全部文档。
在 APEX-Agents 上评估一个前沿模型约花 1.09 万美元、跑 2.7 天,让'持续选型'贵到做不起。DualViewEval 用 20 个任务的迷你集加 6 个过程信号,把 Agent 评估压缩 24–40 倍、误差还更低。本文拆解方法,并给出 LoopRouter 的选型与路由落地视角。
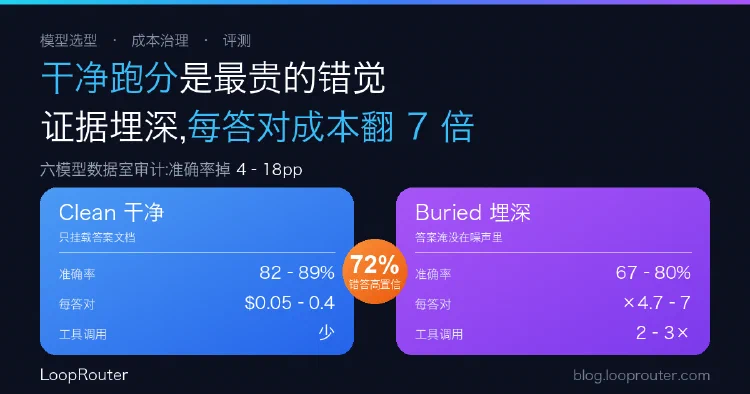
一项对六家前沿模型的「数据室审计」发现:把答案证据从干净文档挪进带噪声的真实文件堆后,准确率掉 4–18 个百分点,而每答对一题的成本涨了 4.7–7 倍。更关键的是,模型在变难时的行为分成两派——有的学会说『我不确定』,有的照样满分自信地答错。这决定了你该怎么路由与选型。