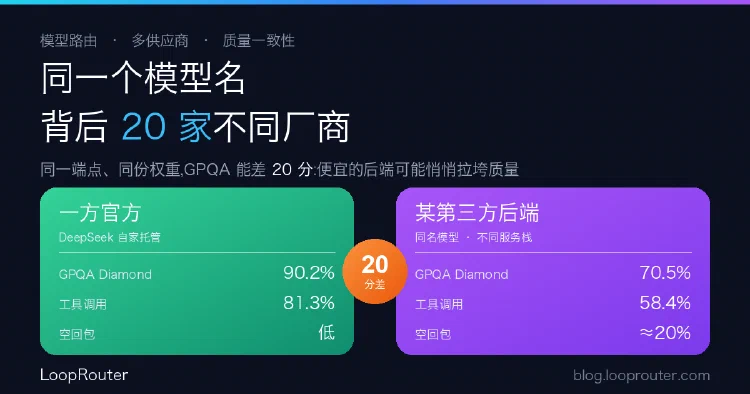
同一个模型名,背后可能是 20 家不同厂商:聚合路由的隐藏质量差,以及企业该怎么治理
OpenRouter 式聚合路由把一个模型名映射到近 20 家后端厂商,同一端点的 GPQA 分数能差 20 个百分点,还会遇到视觉失明、reasoning 参数被忽略、20% 空回包等坑。本文提炼一线实测数据,给出企业接入的路由治理清单。
按时间浏览全部文档。
OpenRouter 式聚合路由把一个模型名映射到近 20 家后端厂商,同一端点的 GPQA 分数能差 20 个百分点,还会遇到视觉失明、reasoning 参数被忽略、20% 空回包等坑。本文提炼一线实测数据,给出企业接入的路由治理清单。
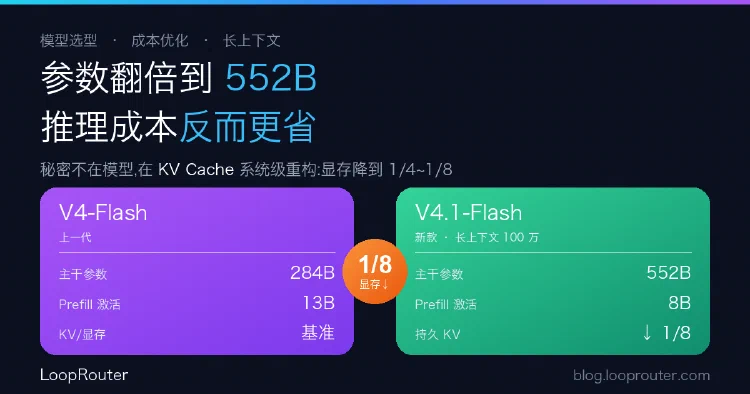
DeepSeek V4.1-Flash 主干参数从 284B 涨到 552B,推理成本却不升反降。关键在于对 KV Cache 的系统级重构:CED 架构、跨层共享 KV、FP4 量化,把百万 Token 场景下的显存降到上一代的 1/4 到 1/8。本文拆解方法与数据,并从模型选型角度分析:为什么长上下文 Agent 的真实成本不能只看每 Token 单价。
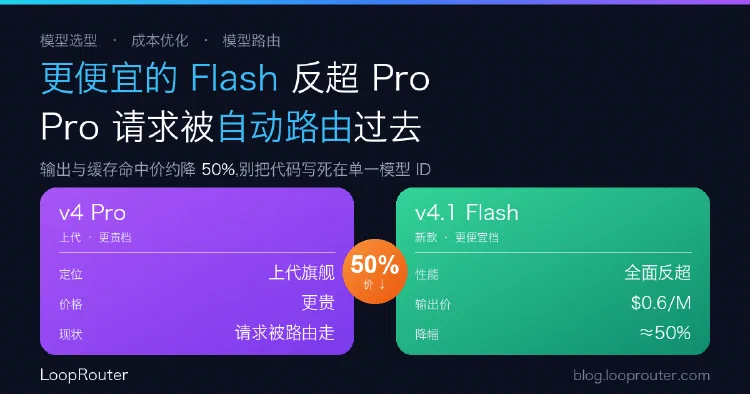
DeepSeek 称 v4.1 Flash 在性能、成本、速度上全面超过 v4 Pro,输出与缓存命中价约降 50%,并在 v4.1 Pro 发布前把所有 Pro 请求路由到 Flash 按 Flash 价计费。本文拆解定价与这次「官方路由」对接入方的含义。
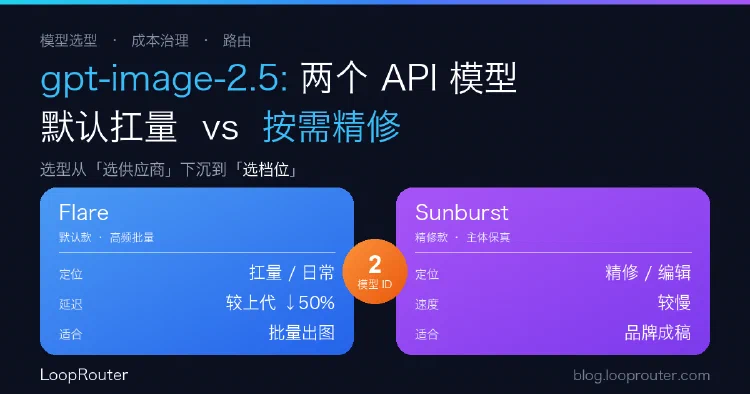
ChatGPT Images 2.5 在 API 里上了 sunburst 和 flare 两个模型 ID。结论先行地讲清两者分工、计费口径的争议,以及多模型统一接入时的路由与兜底思路。
Azure AI Foundry 的模型路由从 2 区扩到 28 区,新增 Claude Opus 4.8 与 GPT-5.6,并提供 Balanced/Quality/Cost 三种路由模式。本文拆解它的选路机制、隐藏计费与上下文窗口陷阱,并给出企业接入前的验证清单。
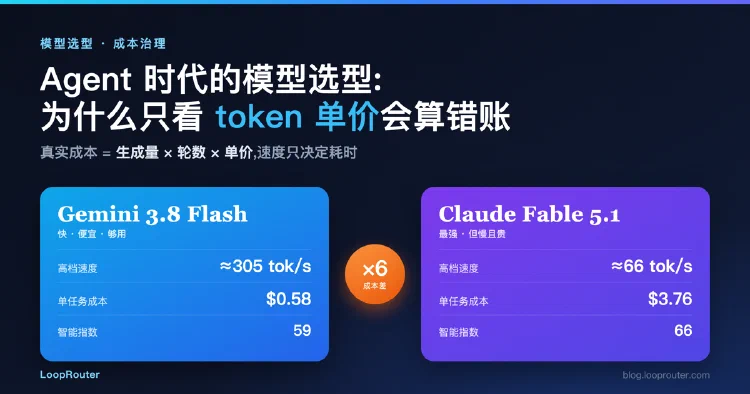
Gemini 3.8 Flash 单价没涨,单任务成本却涨了 40%。Agent 模型的真实开销 ≈ 单任务累计生成 token 数 × 单价,速度只决定端到端耗时;只盯单价会选错。从企业接入与路由治理视角拆解。