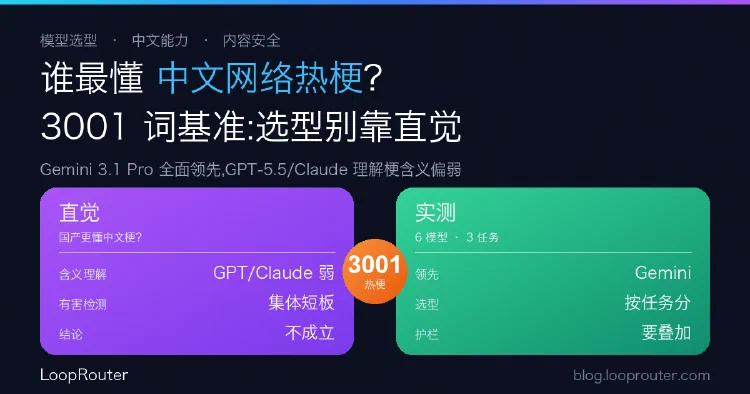
谁最懂中文网络热梗?一份 3001 词基准告诉你选型别靠直觉
选模型做中文内容,很多人默认「国产模型更懂中文梗」。但一份覆盖 3001 个中文网络热梗、6 个主流模型、3 类任务的基准显示:全面领先的是 Gemini 3.1 Pro,GPT-5.5、Claude 在「理解梗的含义」上明显偏弱,而检测「用梗包装的有害内容」几乎所有模型都不及格。从接入与路由视角看,中文选型该按任务拆开做。
按时间浏览全部文档。
选模型做中文内容,很多人默认「国产模型更懂中文梗」。但一份覆盖 3001 个中文网络热梗、6 个主流模型、3 类任务的基准显示:全面领先的是 Gemini 3.1 Pro,GPT-5.5、Claude 在「理解梗的含义」上明显偏弱,而检测「用梗包装的有害内容」几乎所有模型都不及格。从接入与路由视角看,中文选型该按任务拆开做。
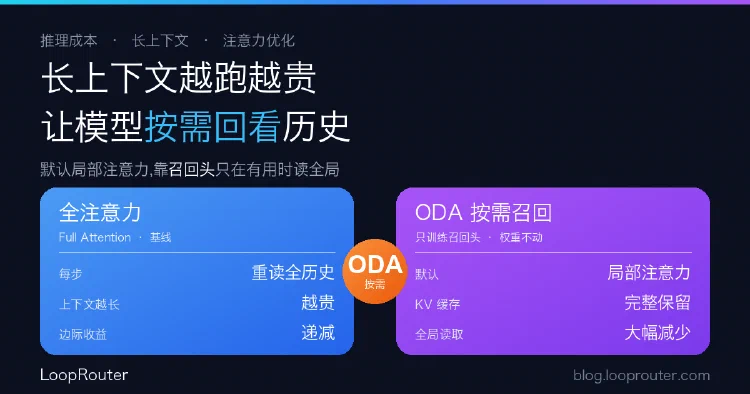
长上下文和 Agent 推理贵,根因之一是全注意力每生成一个 token 都要重读不断变长的历史。arXiv 新论文 On-Demand Attention(ODA)默认用局部注意力,靠一个轻量『召回头』预测『这一步要不要回看全局』,只在有用时才触发全局读取。从接入方视角看,它是同档模型下不同供应商『每 token 成本/延迟』会拉开差距的隐性变量。
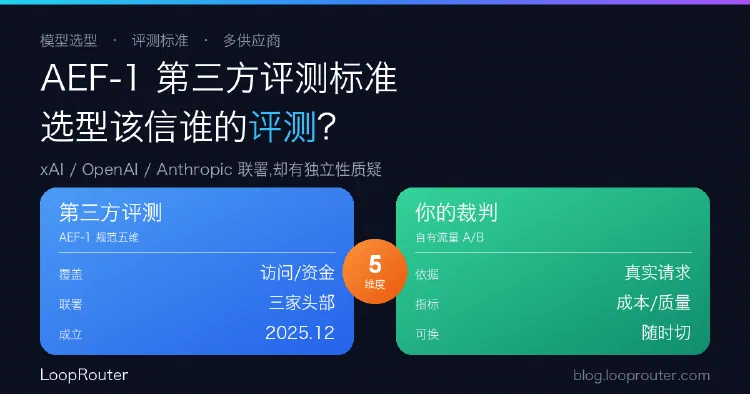
AI Evaluator Forum(2025 年 12 月成立)发布 AEF-1——第三方独立评测的基线标准,规范访问权限、利益冲突、资金关系、回避与透明度五件事,三家头部实验室联署。但同期就有人质疑评测机构与实验室的资金牵连。对做选型的企业,结论很实在:第三方评测在变可信,却仍不能把选型外包给任何单一榜单。
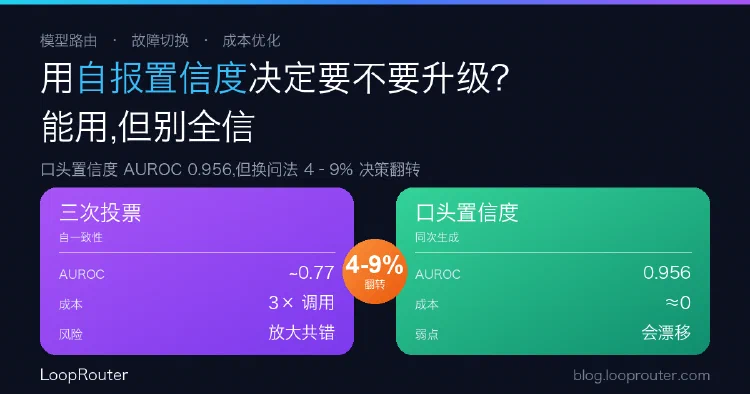
想靠模型自己报的置信度来决定「这条查询要不要升级到更贵的模型」?一份受控测试显示:直接口头报的置信度出奇地准(AUROC 0.956),比三次采样投票(约 0.77)强得多;但它很脆——换个问法,4%–9% 的路由决策就翻了。给置信度路由的落地建议。
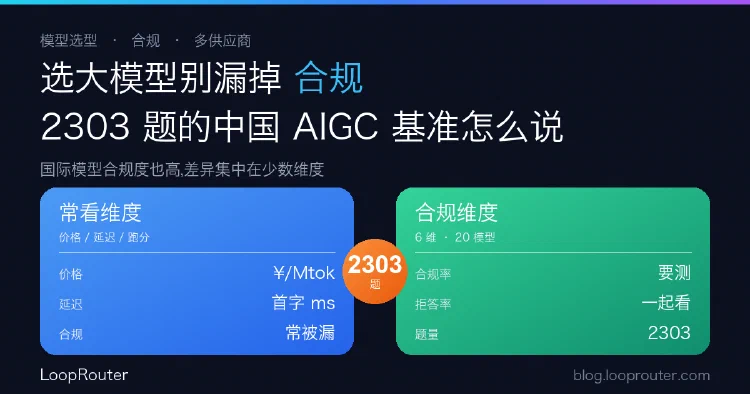
企业选模型常盯着价格、延迟、跑分,却漏了一条硬约束:能不能过中国 AIGC 内容合规要求。一份覆盖 20 个模型、2303 道题、6 个维度的基准显示:连国际模型在标准中文问题上的合规度也很高,模型间的差异主要落在少数几个维度上。从接入与选型视角看合规该怎么纳入。
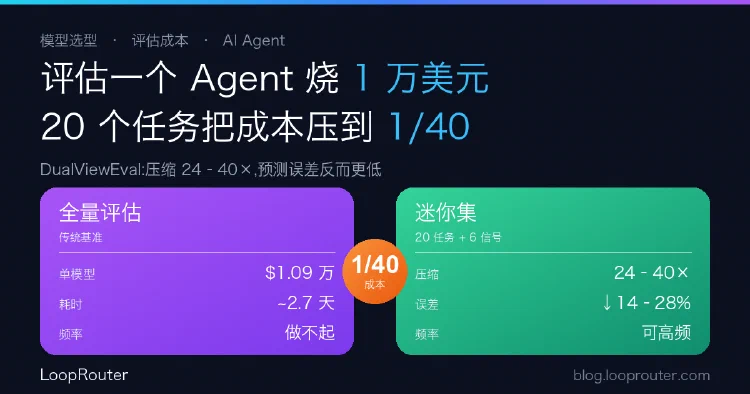
在 APEX-Agents 上评估一个前沿模型约花 1.09 万美元、跑 2.7 天,让'持续选型'贵到做不起。DualViewEval 用 20 个任务的迷你集加 6 个过程信号,把 Agent 评估压缩 24–40 倍、误差还更低。本文拆解方法,并给出 LoopRouter 的选型与路由落地视角。