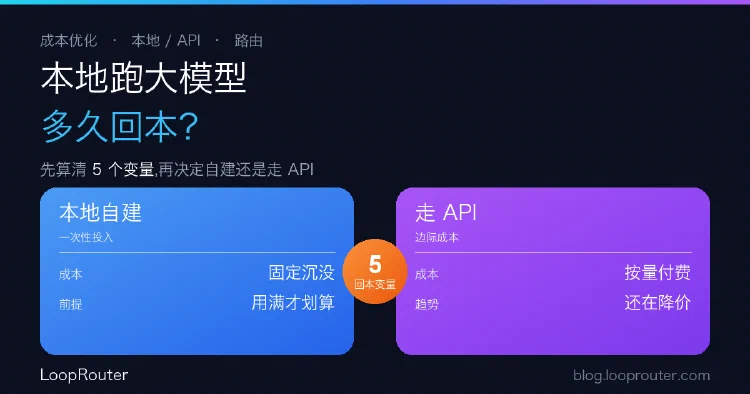
本地跑大模型多久回本?先算清这 5 个变量,再决定自建还是走 API
「买台机器自己跑模型」到底几个月回本,取决于日均 token 量、输入输出比、电费、API 单价,以及一个最容易被忽略的变量——API 价格还在往下掉。本文拆解这套回本测算的框架,并给出 LoopRouter 视角:多数团队的最优解不是二选一,而是本地与 API 之间按任务路由。
按时间浏览全部文档。
「买台机器自己跑模型」到底几个月回本,取决于日均 token 量、输入输出比、电费、API 单价,以及一个最容易被忽略的变量——API 价格还在往下掉。本文拆解这套回本测算的框架,并给出 LoopRouter 视角:多数团队的最优解不是二选一,而是本地与 API 之间按任务路由。
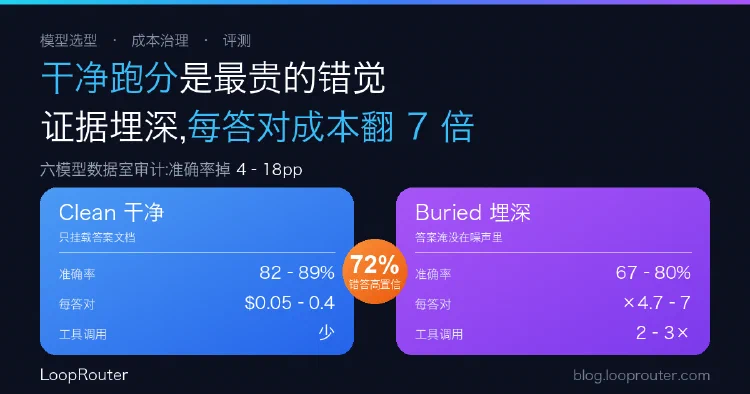
一项对六家前沿模型的「数据室审计」发现:把答案证据从干净文档挪进带噪声的真实文件堆后,准确率掉 4–18 个百分点,而每答对一题的成本涨了 4.7–7 倍。更关键的是,模型在变难时的行为分成两派——有的学会说『我不确定』,有的照样满分自信地答错。这决定了你该怎么路由与选型。
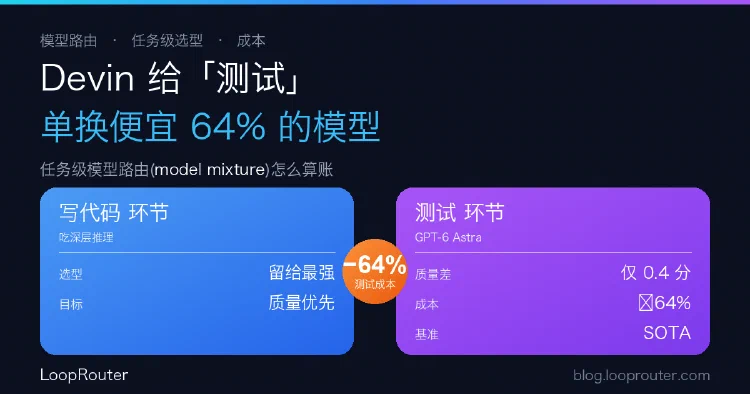
Cognition 让 Devin 用 GPT-6 Astra 专跑测试与验证环节——在 FrontierCode 1.1 上只落后 Fable 5 约 0.4 分,成本却低 64%。本文拆解这套「按任务分模型」的路由逻辑、省钱的真实边界,以及自建同类能力前必须验证的一个数字。
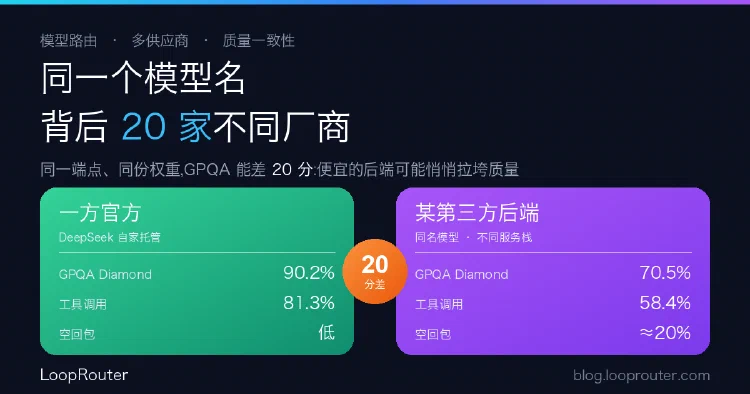
OpenRouter 式聚合路由把一个模型名映射到近 20 家后端厂商,同一端点的 GPQA 分数能差 20 个百分点,还会遇到视觉失明、reasoning 参数被忽略、20% 空回包等坑。本文提炼一线实测数据,给出企业接入的路由治理清单。
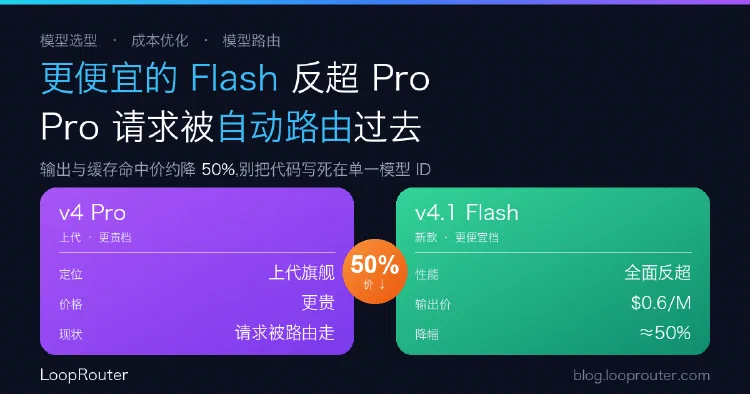
DeepSeek 称 v4.1 Flash 在性能、成本、速度上全面超过 v4 Pro,输出与缓存命中价约降 50%,并在 v4.1 Pro 发布前把所有 Pro 请求路由到 Flash 按 Flash 价计费。本文拆解定价与这次「官方路由」对接入方的含义。
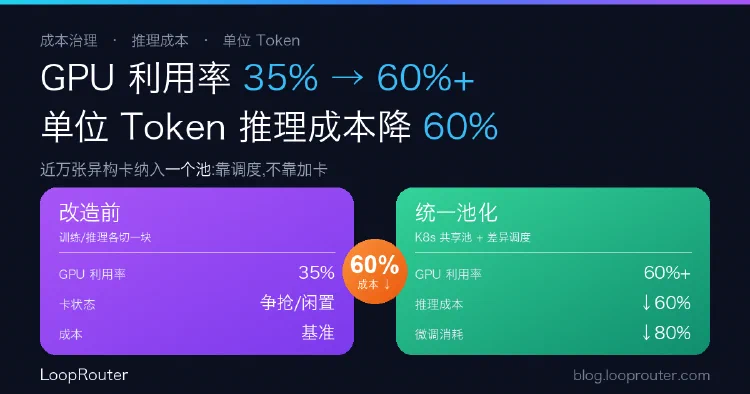
招商银行用 Kubernetes 统一纳管近万张异构加速卡,GPU 利用率从 35% 提到 60%+,每百万 Token 推理成本下降超 60%。本文拆解它的池化调度打法,并给没有万卡的团队一条应用层降本路径。