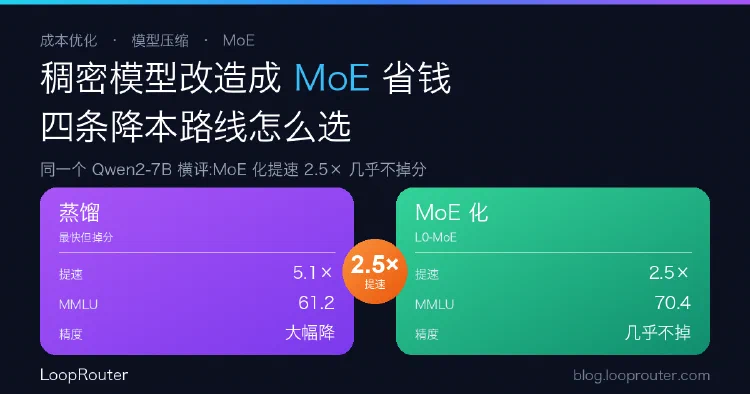
把稠密模型改造成 MoE 来省钱:量化、剪枝、蒸馏、MoE 化怎么选
自托管模型想降本,常见四条路:量化、剪枝、蒸馏、把稠密模型改造成 MoE。一份 ACL 论文用同一个 Qwen2-7B 做横评显示:MoE 化能在几乎不掉分的前提下提速 2–2.5 倍,蒸馏最快但精度损失最大。从接入与成本治理视角看,「模型内压缩」和「接入层路由」是两条互补的降本路线。
按时间浏览全部文档。
自托管模型想降本,常见四条路:量化、剪枝、蒸馏、把稠密模型改造成 MoE。一份 ACL 论文用同一个 Qwen2-7B 做横评显示:MoE 化能在几乎不掉分的前提下提速 2–2.5 倍,蒸馏最快但精度损失最大。从接入与成本治理视角看,「模型内压缩」和「接入层路由」是两条互补的降本路线。
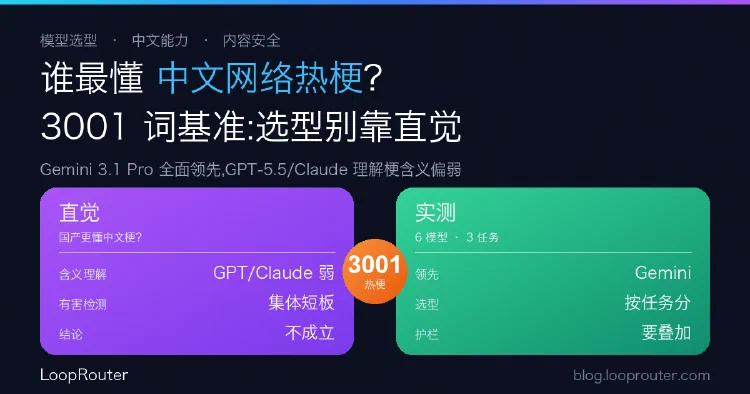
选模型做中文内容,很多人默认「国产模型更懂中文梗」。但一份覆盖 3001 个中文网络热梗、6 个主流模型、3 类任务的基准显示:全面领先的是 Gemini 3.1 Pro,GPT-5.5、Claude 在「理解梗的含义」上明显偏弱,而检测「用梗包装的有害内容」几乎所有模型都不及格。从接入与路由视角看,中文选型该按任务拆开做。
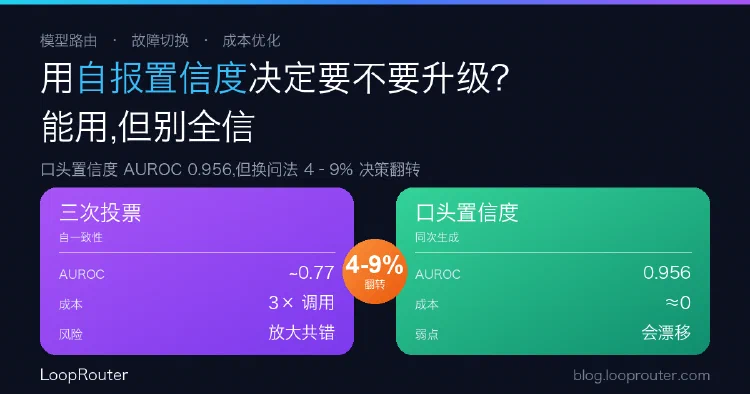
想靠模型自己报的置信度来决定「这条查询要不要升级到更贵的模型」?一份受控测试显示:直接口头报的置信度出奇地准(AUROC 0.956),比三次采样投票(约 0.77)强得多;但它很脆——换个问法,4%–9% 的路由决策就翻了。给置信度路由的落地建议。
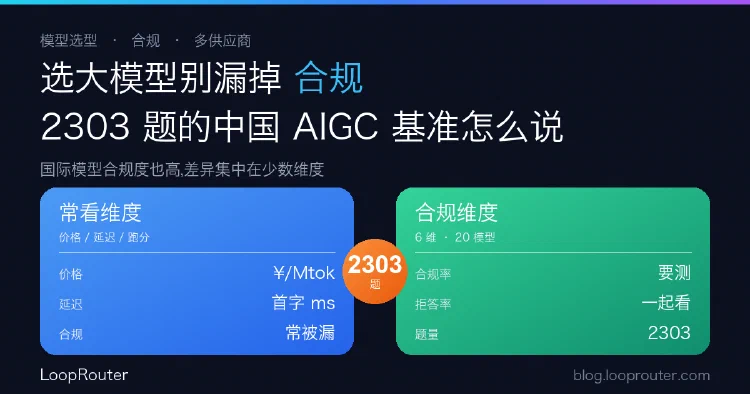
企业选模型常盯着价格、延迟、跑分,却漏了一条硬约束:能不能过中国 AIGC 内容合规要求。一份覆盖 20 个模型、2303 道题、6 个维度的基准显示:连国际模型在标准中文问题上的合规度也很高,模型间的差异主要落在少数几个维度上。从接入与选型视角看合规该怎么纳入。
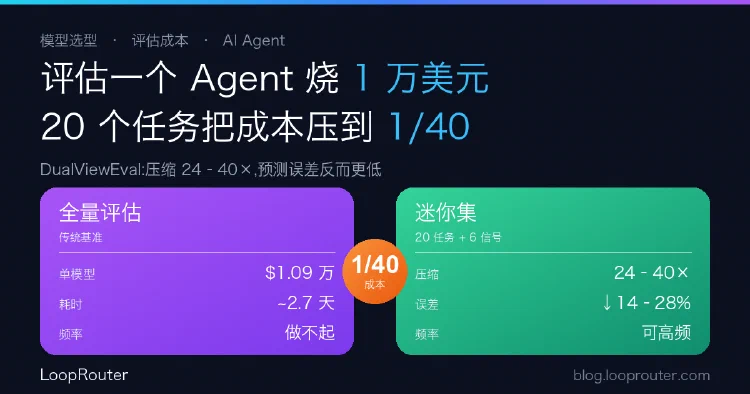
在 APEX-Agents 上评估一个前沿模型约花 1.09 万美元、跑 2.7 天,让'持续选型'贵到做不起。DualViewEval 用 20 个任务的迷你集加 6 个过程信号,把 Agent 评估压缩 24–40 倍、误差还更低。本文拆解方法,并给出 LoopRouter 的选型与路由落地视角。
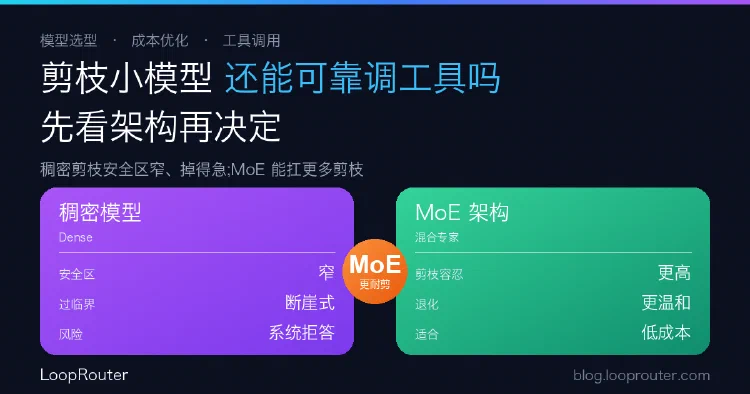
剪枝能压低大模型部署成本,却会先削弱工具调用里最具体的部分(设备、参数、取值)。一项跨 4 个模型、1.95 万条实例的研究显示:稠密模型剪枝「安全区窄、掉得急」,MoE 能扛更多剪枝;剪太狠还会让模型系统性拒答。从 Agent 接入与模型路由视角给出选型建议。