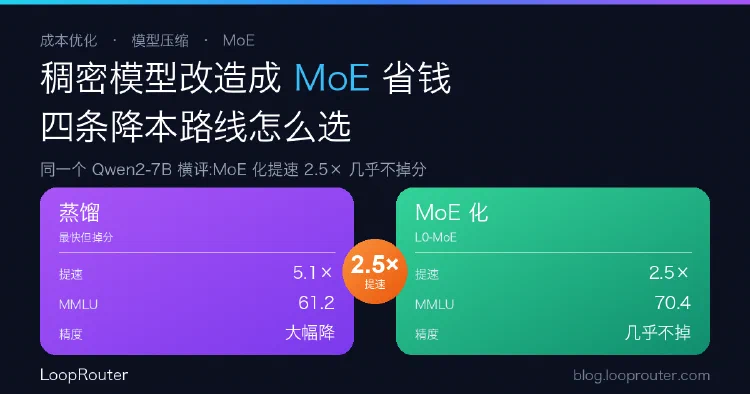
把稠密模型改造成 MoE 来省钱:量化、剪枝、蒸馏、MoE 化怎么选
自托管模型想降本,常见四条路:量化、剪枝、蒸馏、把稠密模型改造成 MoE。一份 ACL 论文用同一个 Qwen2-7B 做横评显示:MoE 化能在几乎不掉分的前提下提速 2–2.5 倍,蒸馏最快但精度损失最大。从接入与成本治理视角看,「模型内压缩」和「接入层路由」是两条互补的降本路线。
按时间浏览全部文档。
自托管模型想降本,常见四条路:量化、剪枝、蒸馏、把稠密模型改造成 MoE。一份 ACL 论文用同一个 Qwen2-7B 做横评显示:MoE 化能在几乎不掉分的前提下提速 2–2.5 倍,蒸馏最快但精度损失最大。从接入与成本治理视角看,「模型内压缩」和「接入层路由」是两条互补的降本路线。
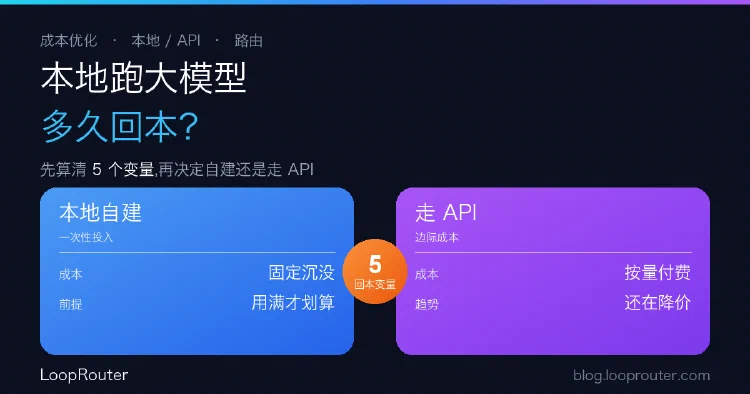
「买台机器自己跑模型」到底几个月回本,取决于日均 token 量、输入输出比、电费、API 单价,以及一个最容易被忽略的变量——API 价格还在往下掉。本文拆解这套回本测算的框架,并给出 LoopRouter 视角:多数团队的最优解不是二选一,而是本地与 API 之间按任务路由。
Qwen 3.8 27B 是能塞进单机的 Apache 2 视觉模型,但默认推理档位会让成本和延迟失控。从企业接入与成本治理角度拆解它的选型价值。