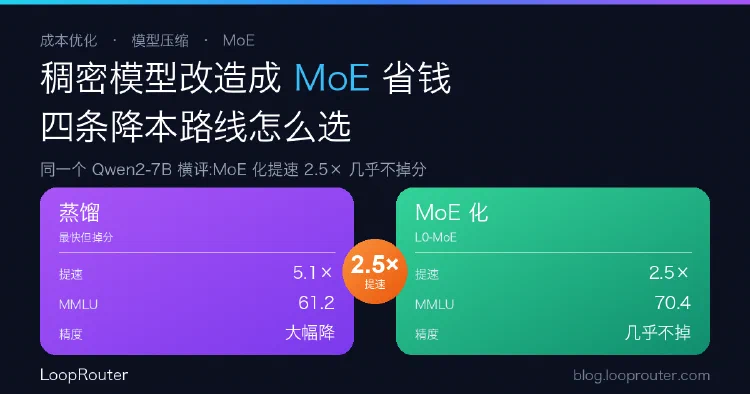
把稠密模型改造成 MoE 来省钱:量化、剪枝、蒸馏、MoE 化怎么选
自托管模型想降本,常见四条路:量化、剪枝、蒸馏、把稠密模型改造成 MoE。一份 ACL 论文用同一个 Qwen2-7B 做横评显示:MoE 化能在几乎不掉分的前提下提速 2–2.5 倍,蒸馏最快但精度损失最大。从接入与成本治理视角看,「模型内压缩」和「接入层路由」是两条互补的降本路线。
按时间浏览全部文档。
自托管模型想降本,常见四条路:量化、剪枝、蒸馏、把稠密模型改造成 MoE。一份 ACL 论文用同一个 Qwen2-7B 做横评显示:MoE 化能在几乎不掉分的前提下提速 2–2.5 倍,蒸馏最快但精度损失最大。从接入与成本治理视角看,「模型内压缩」和「接入层路由」是两条互补的降本路线。
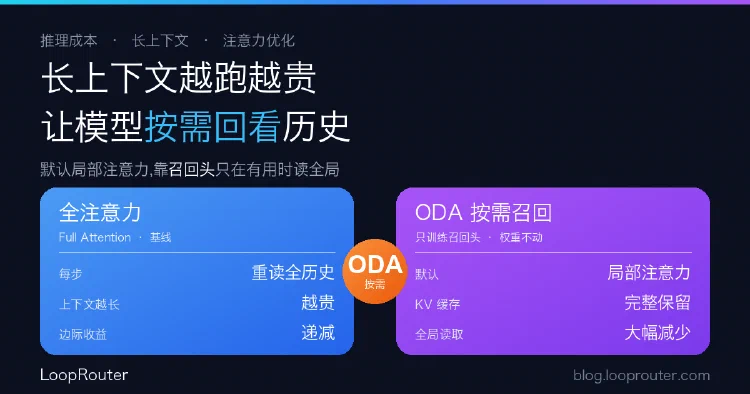
长上下文和 Agent 推理贵,根因之一是全注意力每生成一个 token 都要重读不断变长的历史。arXiv 新论文 On-Demand Attention(ODA)默认用局部注意力,靠一个轻量『召回头』预测『这一步要不要回看全局』,只在有用时才触发全局读取。从接入方视角看,它是同档模型下不同供应商『每 token 成本/延迟』会拉开差距的隐性变量。
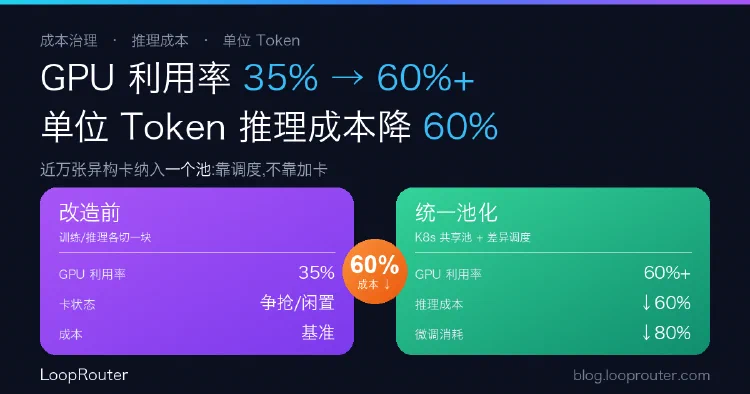
招商银行用 Kubernetes 统一纳管近万张异构加速卡,GPU 利用率从 35% 提到 60%+,每百万 Token 推理成本下降超 60%。本文拆解它的池化调度打法,并给没有万卡的团队一条应用层降本路径。
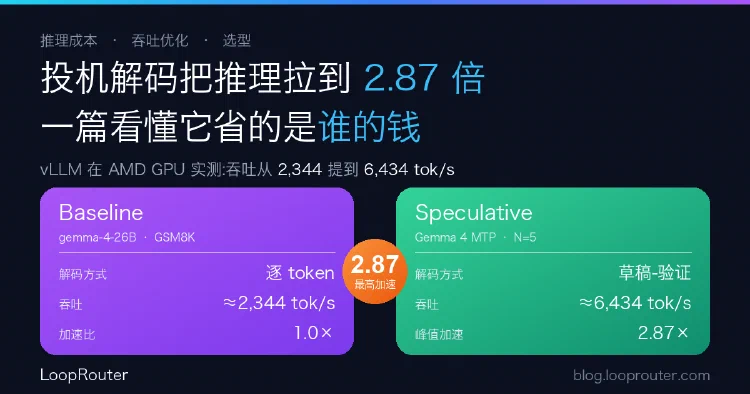
vLLM 在 AMD MI300X/MI355X 上实测:投机解码(speculative decoding)最高 2.87× 加速,吞吐从约 2,344 提到 6,434 tok/s。但收益强依赖模型与配置,部分场景反而低于基线。从接入方视角看,这是选型时该关注的隐性成本变量。
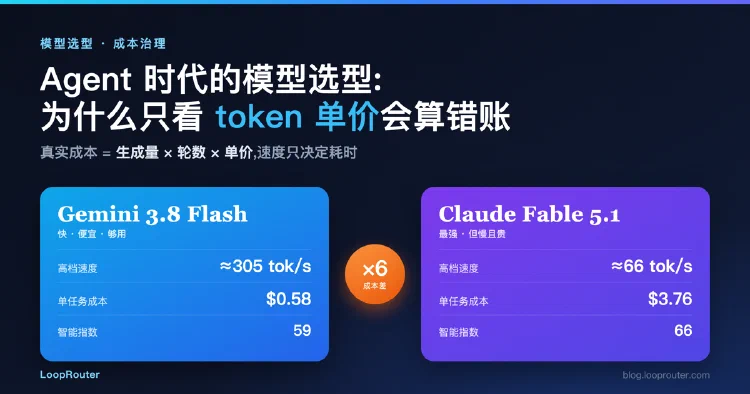
Gemini 3.8 Flash 单价没涨,单任务成本却涨了 40%。Agent 模型的真实开销 ≈ 单任务累计生成 token 数 × 单价,速度只决定端到端耗时;只盯单价会选错。从企业接入与路由治理视角拆解。
Qwen 3.8 27B 是能塞进单机的 Apache 2 视觉模型,但默认推理档位会让成本和延迟失控。从企业接入与成本治理角度拆解它的选型价值。