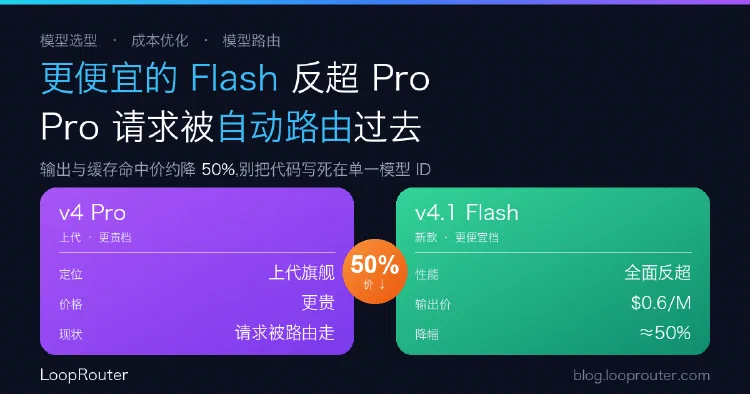
DeepSeek v4.1 Flash 全面超过 v4 Pro:更便宜的新模型发布,Pro 请求被自动路由过去
DeepSeek 称 v4.1 Flash 在性能、成本、速度上全面超过 v4 Pro,输出与缓存命中价约降 50%,并在 v4.1 Pro 发布前把所有 Pro 请求路由到 Flash 按 Flash 价计费。本文拆解定价与这次「官方路由」对接入方的含义。
按时间浏览全部文档。
DeepSeek 称 v4.1 Flash 在性能、成本、速度上全面超过 v4 Pro,输出与缓存命中价约降 50%,并在 v4.1 Pro 发布前把所有 Pro 请求路由到 Flash 按 Flash 价计费。本文拆解定价与这次「官方路由」对接入方的含义。
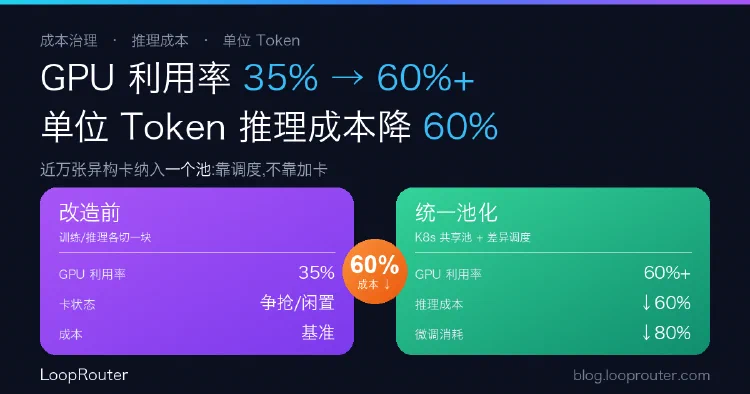
招商银行用 Kubernetes 统一纳管近万张异构加速卡,GPU 利用率从 35% 提到 60%+,每百万 Token 推理成本下降超 60%。本文拆解它的池化调度打法,并给没有万卡的团队一条应用层降本路径。
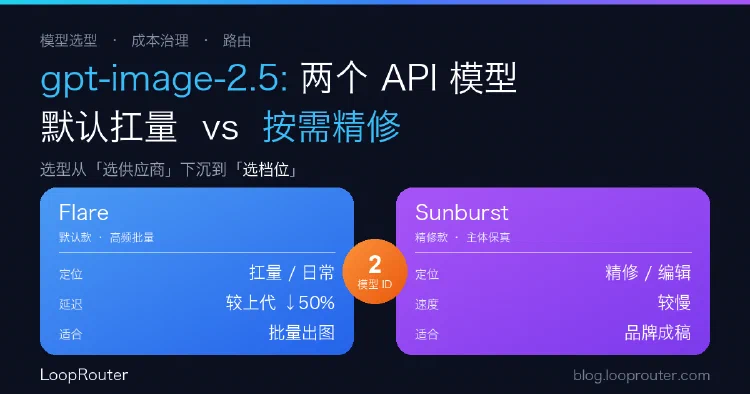
ChatGPT Images 2.5 在 API 里上了 sunburst 和 flare 两个模型 ID。结论先行地讲清两者分工、计费口径的争议,以及多模型统一接入时的路由与兜底思路。
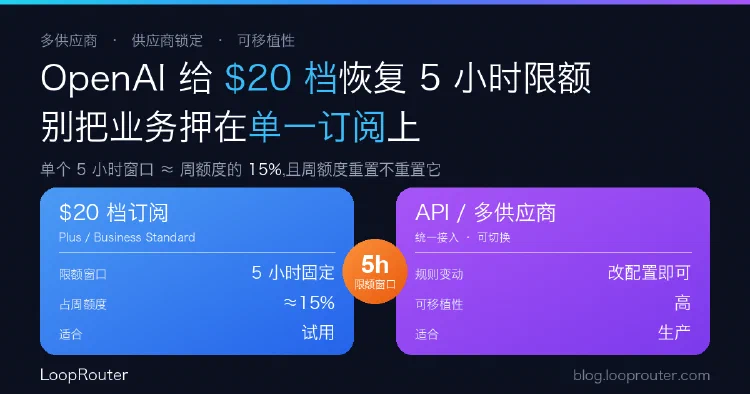
OpenAI 对 Plus 和 Business Standard 恢复 5 小时固定窗口限额,单窗口约占每周额度 15%,且周额度重置不重置该窗口。从「补贴陷阱」与供应商锁定角度,拆解订阅、API 与多供应商策略该怎么选。
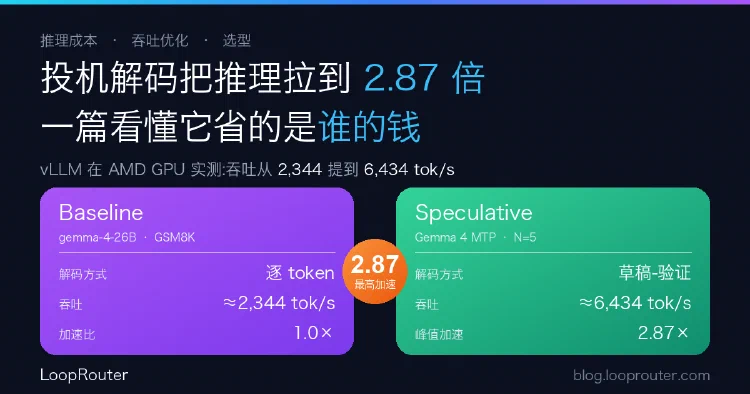
vLLM 在 AMD MI300X/MI355X 上实测:投机解码(speculative decoding)最高 2.87× 加速,吞吐从约 2,344 提到 6,434 tok/s。但收益强依赖模型与配置,部分场景反而低于基线。从接入方视角看,这是选型时该关注的隐性成本变量。
Azure AI Foundry 的模型路由从 2 区扩到 28 区,新增 Claude Opus 4.8 与 GPT-5.6,并提供 Balanced/Quality/Cost 三种路由模式。本文拆解它的选路机制、隐藏计费与上下文窗口陷阱,并给出企业接入前的验证清单。