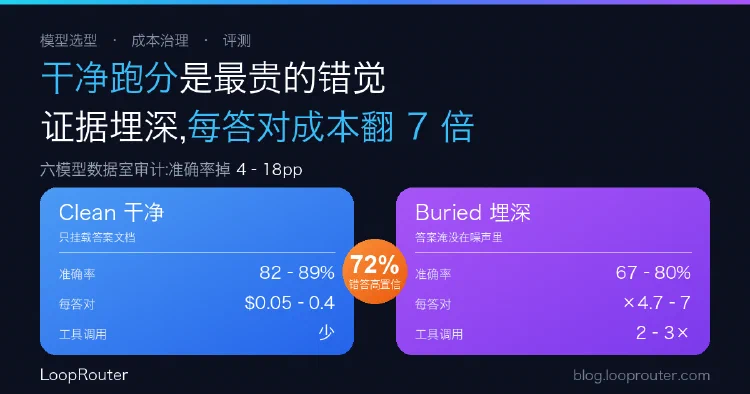
选模型别只看跑分:证据一「埋深」,每答对一题的成本翻了 4.7–7 倍
一项对六家前沿模型的「数据室审计」发现:把答案证据从干净文档挪进带噪声的真实文件堆后,准确率掉 4–18 个百分点,而每答对一题的成本涨了 4.7–7 倍。更关键的是,模型在变难时的行为分成两派——有的学会说『我不确定』,有的照样满分自信地答错。这决定了你该怎么路由与选型。
按时间浏览全部文档。
一项对六家前沿模型的「数据室审计」发现:把答案证据从干净文档挪进带噪声的真实文件堆后,准确率掉 4–18 个百分点,而每答对一题的成本涨了 4.7–7 倍。更关键的是,模型在变难时的行为分成两派——有的学会说『我不确定』,有的照样满分自信地答错。这决定了你该怎么路由与选型。
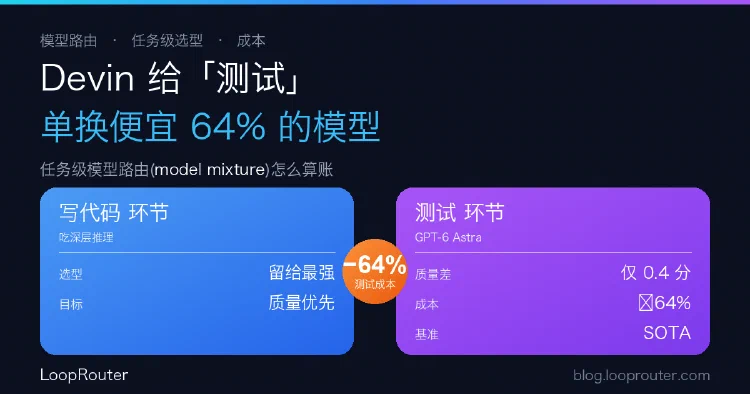
Cognition 让 Devin 用 GPT-6 Astra 专跑测试与验证环节——在 FrontierCode 1.1 上只落后 Fable 5 约 0.4 分,成本却低 64%。本文拆解这套「按任务分模型」的路由逻辑、省钱的真实边界,以及自建同类能力前必须验证的一个数字。
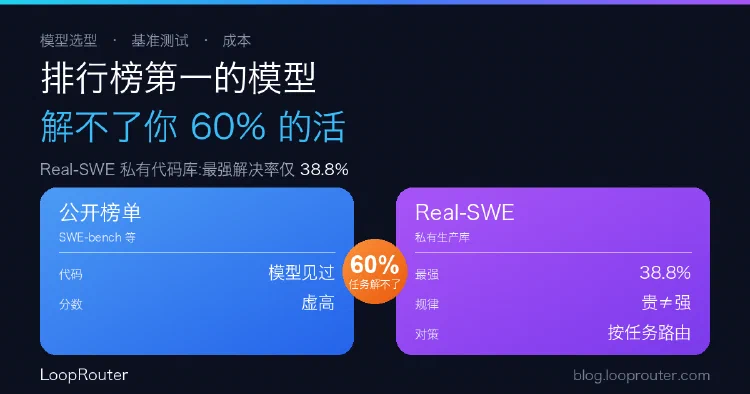
Specific Labs 的 Real-SWE 在真实企业私有代码库上测模型,最强的 Fable 5.1 解决率也只有 38.8%,且贵不等于强。本文解读数据,给出企业选型与多模型路由的落地建议。
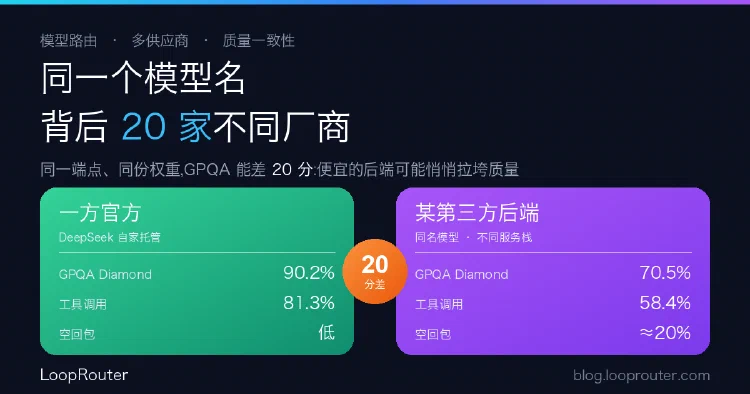
OpenRouter 式聚合路由把一个模型名映射到近 20 家后端厂商,同一端点的 GPQA 分数能差 20 个百分点,还会遇到视觉失明、reasoning 参数被忽略、20% 空回包等坑。本文提炼一线实测数据,给出企业接入的路由治理清单。
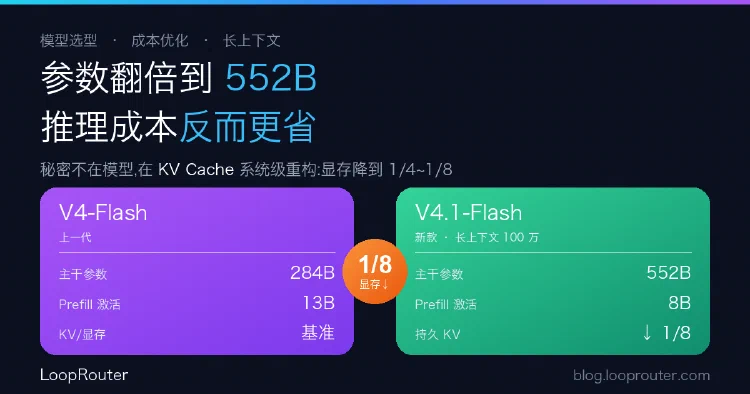
DeepSeek V4.1-Flash 主干参数从 284B 涨到 552B,推理成本却不升反降。关键在于对 KV Cache 的系统级重构:CED 架构、跨层共享 KV、FP4 量化,把百万 Token 场景下的显存降到上一代的 1/4 到 1/8。本文拆解方法与数据,并从模型选型角度分析:为什么长上下文 Agent 的真实成本不能只看每 Token 单价。
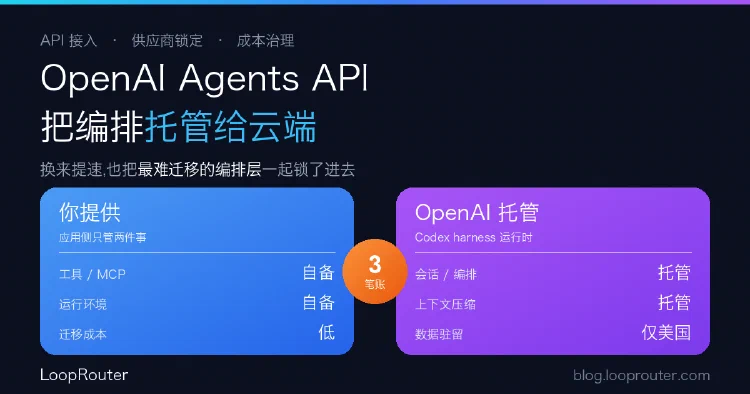
OpenAI 推出托管式 Agents API,由 Codex harness 负责会话、编排、上下文压缩与恢复,应用只需提供工具和运行环境。本文拆解它的能力边界、计费方式与两大限制(仅美国数据驻留、不支持 ZDR),并从多模型接入视角分析该不该把编排层交给单一供应商。