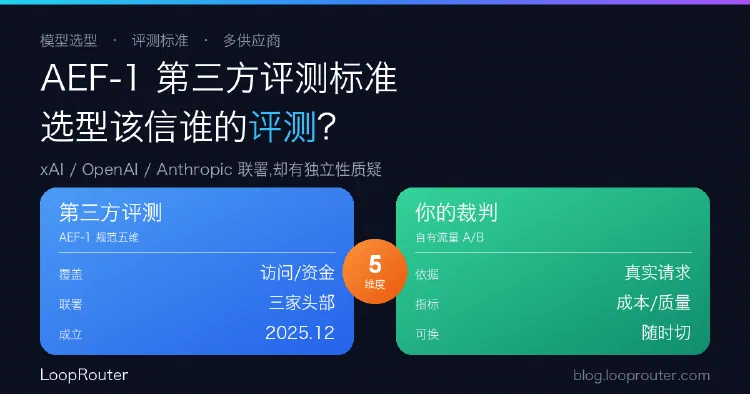
xAI、OpenAI、Anthropic 联署 AEF-1 第三方评测标准:企业选型到底该信谁的评测?
AI Evaluator Forum(2025 年 12 月成立)发布 AEF-1——第三方独立评测的基线标准,规范访问权限、利益冲突、资金关系、回避与透明度五件事,三家头部实验室联署。但同期就有人质疑评测机构与实验室的资金牵连。对做选型的企业,结论很实在:第三方评测在变可信,却仍不能把选型外包给任何单一榜单。
按时间浏览全部文档。
AI Evaluator Forum(2025 年 12 月成立)发布 AEF-1——第三方独立评测的基线标准,规范访问权限、利益冲突、资金关系、回避与透明度五件事,三家头部实验室联署。但同期就有人质疑评测机构与实验室的资金牵连。对做选型的企业,结论很实在:第三方评测在变可信,却仍不能把选型外包给任何单一榜单。
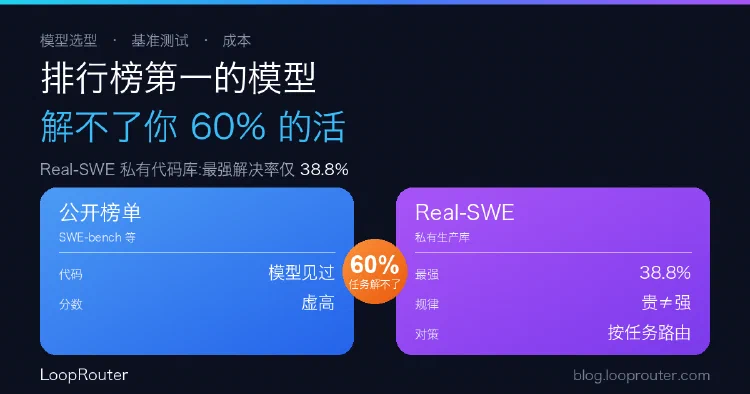
Specific Labs 的 Real-SWE 在真实企业私有代码库上测模型,最强的 Fable 5.1 解决率也只有 38.8%,且贵不等于强。本文解读数据,给出企业选型与多模型路由的落地建议。