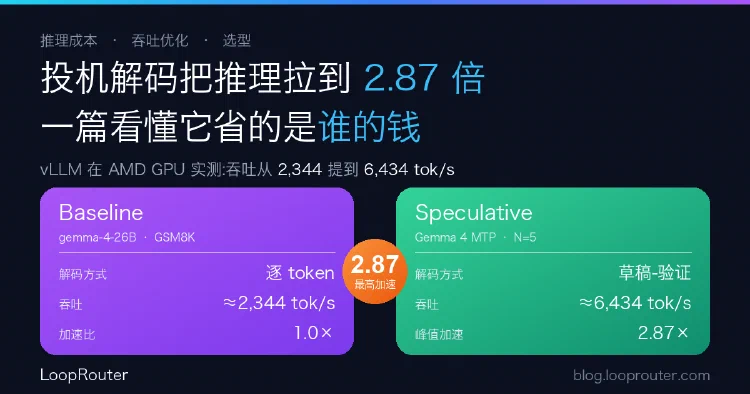
2026-09-08投机解码能把推理速度拉到 2.87 倍:一篇看懂它省的是谁的钱vLLM 在 AMD MI300X/MI355X 上实测:投机解码(speculative decoding)最高 2.87× 加速,吞吐从约 2,344 提到 6,434 tok/s。但收益强依赖模型与配置,部分场景反而低于基线。从接入方视角看,这是选型时该关注的隐性成本变量。