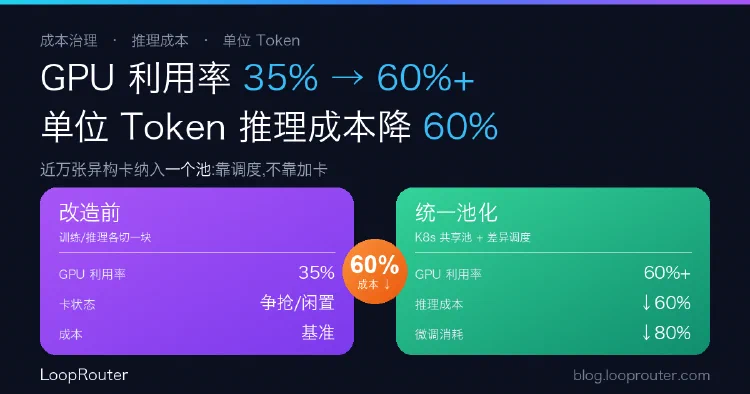
招商银行把 GPU 利用率从 35% 拉到 60%:单位 Token 推理成本降 60% 是怎么做到的
招商银行用 Kubernetes 统一纳管近万张异构加速卡,GPU 利用率从 35% 提到 60%+,每百万 Token 推理成本下降超 60%。本文拆解它的池化调度打法,并给没有万卡的团队一条应用层降本路径。
精选文档
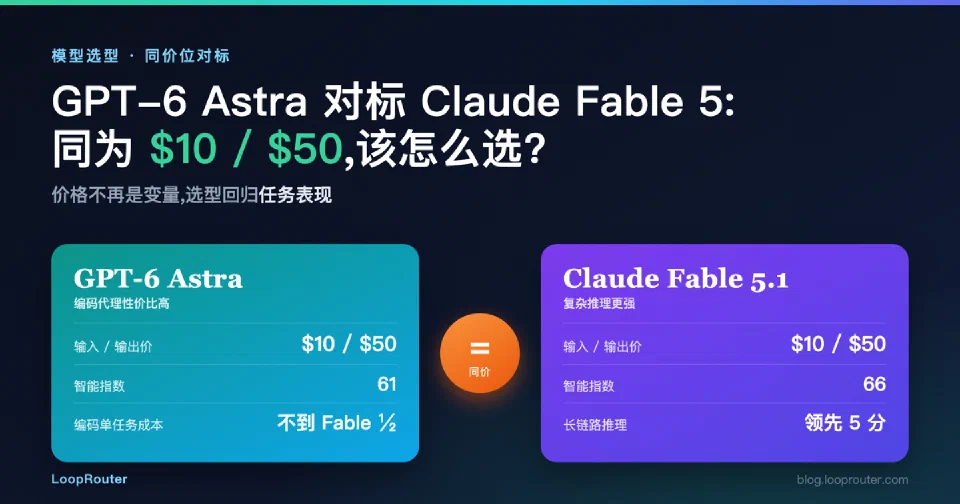
GPT-6 Astra API 定价为输入 10 美元、输出 50 美元每百万 token,与 Claude Fable 5/5.1 完全一致。本文整理基准数据与适用边界,给出同价位选型思路。
持续沉淀模型接入、路由策略、成本控制与 AI 工程实践。
招商银行用 Kubernetes 统一纳管近万张异构加速卡,GPU 利用率从 35% 提到 60%+,每百万 Token 推理成本下降超 60%。本文拆解它的池化调度打法,并给没有万卡的团队一条应用层降本路径。
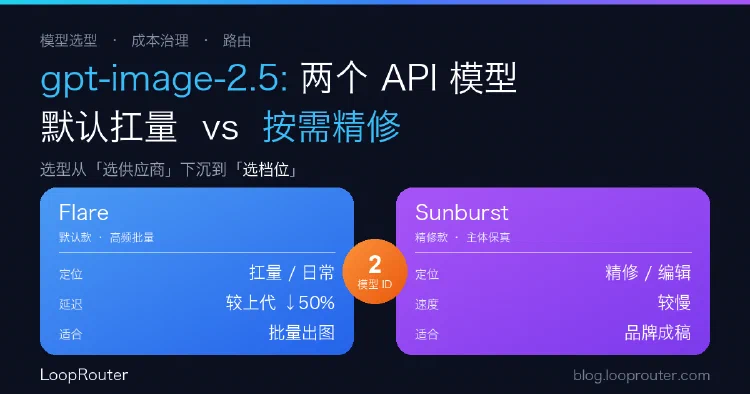
ChatGPT Images 2.5 在 API 里上了 sunburst 和 flare 两个模型 ID。结论先行地讲清两者分工、计费口径的争议,以及多模型统一接入时的路由与兜底思路。
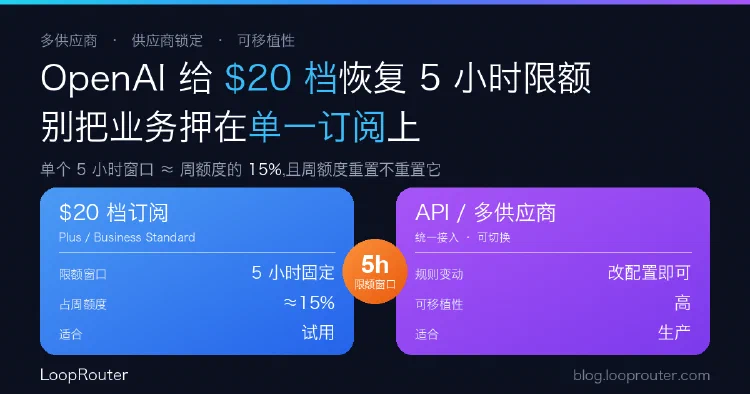
OpenAI 对 Plus 和 Business Standard 恢复 5 小时固定窗口限额,单窗口约占每周额度 15%,且周额度重置不重置该窗口。从「补贴陷阱」与供应商锁定角度,拆解订阅、API 与多供应商策略该怎么选。
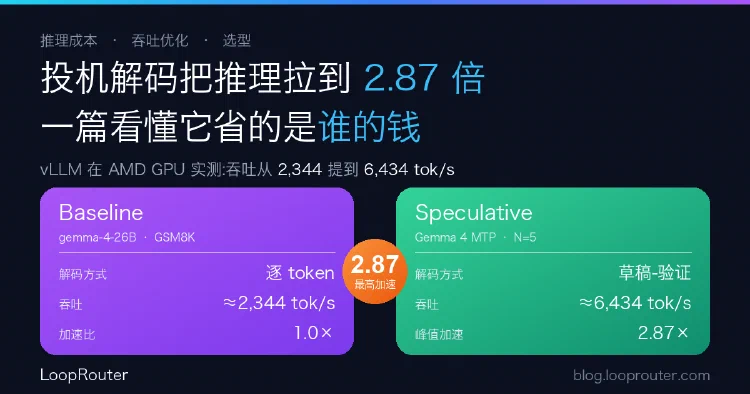
vLLM 在 AMD MI300X/MI355X 上实测:投机解码(speculative decoding)最高 2.87× 加速,吞吐从约 2,344 提到 6,434 tok/s。但收益强依赖模型与配置,部分场景反而低于基线。从接入方视角看,这是选型时该关注的隐性成本变量。
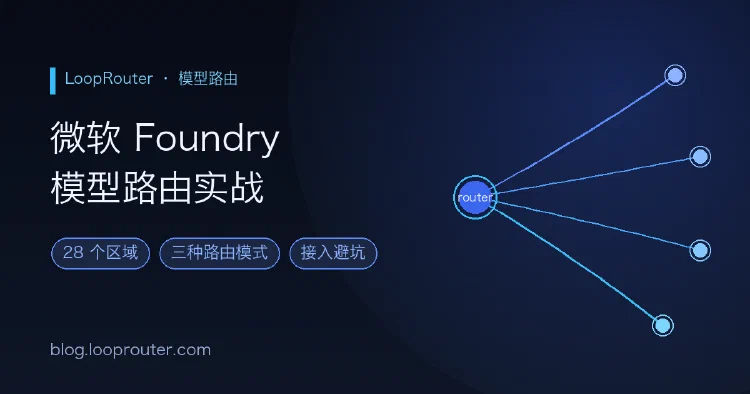
Azure AI Foundry 的模型路由从 2 区扩到 28 区,新增 Claude Opus 4.8 与 GPT-5.6,并提供 Balanced/Quality/Cost 三种路由模式。本文拆解它的选路机制、隐藏计费与上下文窗口陷阱,并给出企业接入前的验证清单。
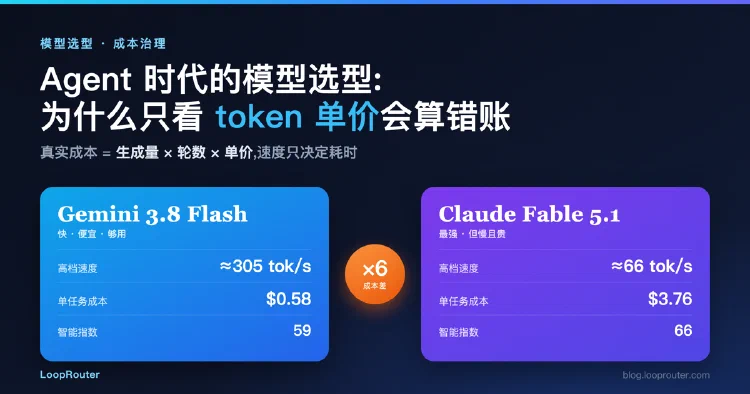
Gemini 3.8 Flash 单价没涨,单任务成本却涨了 40%。Agent 模型的真实开销 ≈ 单任务累计生成 token 数 × 单价,速度只决定端到端耗时;只盯单价会选错。从企业接入与路由治理视角拆解。
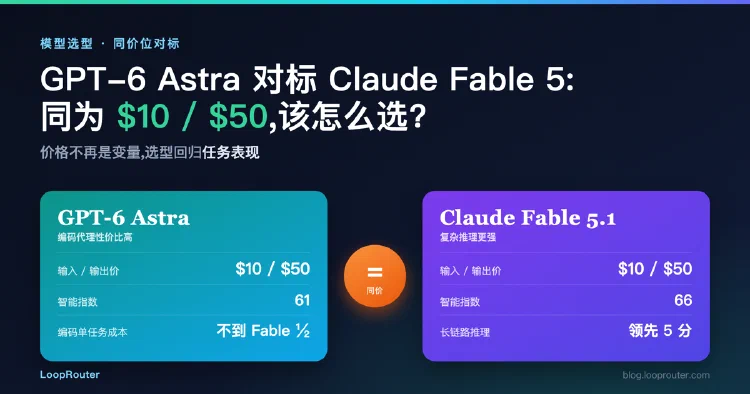
GPT-6 Astra API 定价为输入 10 美元、输出 50 美元每百万 token,与 Claude Fable 5/5.1 完全一致。本文整理基准数据与适用边界,给出同价位选型思路。
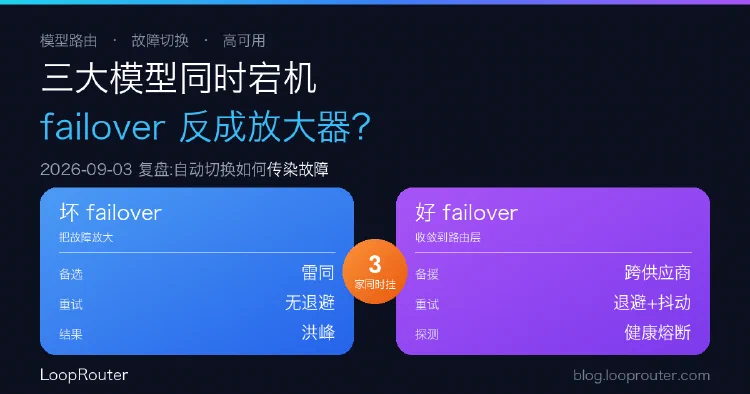
2026 年 9 月 3 日上午,ChatGPT、Claude、Grok 相继报错,唯一接近实锤的根因是 xAI 孟菲斯算力中心故障。本文复盘时间线与社区推测,分析多供应商故障切换的正确姿势。
Qwen 3.8 27B 是能塞进单机的 Apache 2 视觉模型,但默认推理档位会让成本和延迟失控。从企业接入与成本治理角度拆解它的选型价值。