本文基于 vLLM 官方博客关于 AMD GPU 上投机解码的公开测试整理与二次分析,加入 LoopRouter 的成本/选型视角;原文见文末链接。文中数据反映特定硬件与配置,建议在你自己的负载上复测。
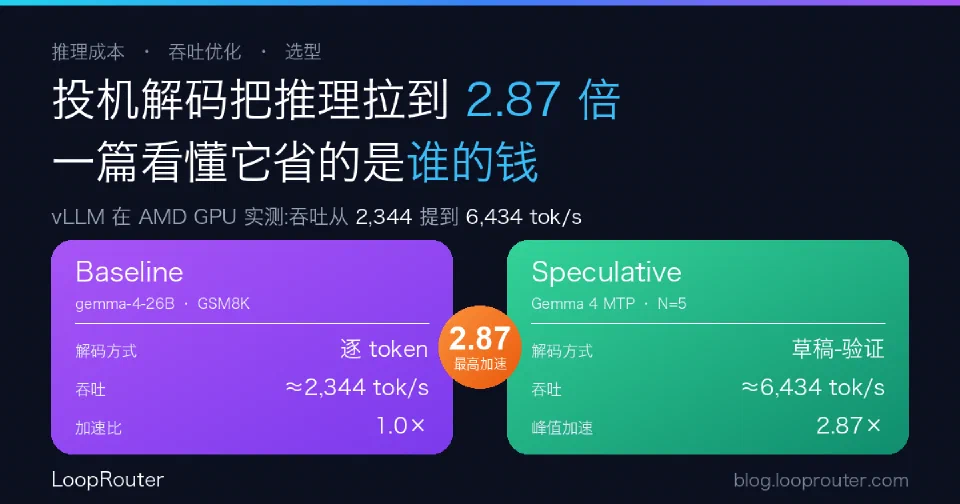
一句话结论:投机解码(speculative decoding)在 vLLM + AMD GPU 上最高能把推理拉到约 2.87× 加速、吞吐从约 2,344 tok/s 提到 6,434 tok/s;但收益强依赖模型和配置,部分场景反而比不开还慢。对自建推理的团队,它是必须实测调优的优化项;对只做 API 接入的团队,它是决定你「每 token 买到多少速度」的隐性变量——该关注,但不必自己动手。
投机解码是怎么省时间的
一句话原理:用便宜的方法先猜、用目标模型一次性验。
传统自回归解码一次只生成一个 token,每个 token 都要过一遍大模型,慢在这里。投机解码的做法是:
- 先用一个「草稿」方法快速提出若干个候选后续 token;
- 让目标模型在一次前向传播里并行验证这批草稿;
- 猜对的连续前缀直接采纳,猜错的地方回退重来。
因为验证是一次算多的,只要草稿的「接受率」够高,就能用更少的前向次数产出同样的 token——输出结果和逐个生成完全一致,省的是时间不是质量。
vLLM 这轮测试在 AMD Instinct MI300X / MI355X(ROCm 平台)上,对比了五种草稿方法:原生 MTP、Gemma 4 MTP、EAGLE-3、DFlash、DSpark,区别在于如何利用目标模型信息、以及 token 是顺序还是并行生成。
加速比:最好能到 2.87×,但强依赖模型
各方法在不同模型上的最佳加速比(节选,均为对应测试的上限值):
| 草稿方法 | 目标模型 | 加速比 | 测试集 |
|---|---|---|---|
| DFlash | gemma-4-26B-A4B-it | 2.87× | MATH500 |
| Gemma 4 MTP | gemma-4-26B-A4B-it | 2.83×(GSM8K 实测 2.74×) | MATH500 / GSM8K |
| DFlash | Kimi-K2.5 | 2.68× | MATH500 |
| Native MTP | Qwen3.5-122B-A10B | 2.20× | MATH500 |
| EAGLE-3 | MiniMax-M3-MXFP8 | 2.09×(N=4) | HumanEval |
吞吐层面的直观例子:gemma-4-26B-A4B-it 基线约 2,344 tok/s(GSM8K),开 Gemma 4 MTP、N=5 后达到 6,434 tok/s——接近 2.7 倍。
关键结论是:没有一个「万能加速比」。 收益取决于模型家族、草稿检查点、工作负载、接受率(acceptance rate)和提议长度这几个变量的组合。同一套方法换个模型,结果可能天差地别。
它也可能帮倒忙:注意这些边界
投机解码不是「开了就快」的免费午餐。原文给出的限制值得贴到调优清单上:
- 可能低于基线:部分 Qwen3-8B 配置慢于不开投机(EAGLE-3 N=1 仅 0.71×)。草稿猜不准时,验证等于白算,还多付草稿成本。
- 收益会到平台期:增大
num_speculative_tokens(一次猜几个)通常在前几个值后就 reaching a plateau,继续加大不一定更快,反而可能因后段草稿接受率下降增加无效开销。 - 配置要实测选:DFlash / DSpark 常在 N=7 附近较优;原生 MTP 建议从 N=1 保守起步再逐步扫描。最终配置必须用代表性工作负载端到端测量后确定。
判断好不好用,看几个指标:吞吐量、平均接受长度(MAL)、总体接受率(AR)、以及逐位置接受率(越往后越容易掉)。
LoopRouter 视角:接入方不必自己搞,但要会比
投机解码本质上是供应商侧的推理优化——它发生在推理引擎里,而不是 API 调用方能直接控制的层面。对只做 API 接入的团队,正确的姿势不是自己去折腾 draft 方法和 N 值,而是:
- 把「吞吐/延迟」当成选型的一等指标,而不只看单价。同一档智能水平下,做了投机解码等优化的供应商能给出更高的 tok/s——这直接改善流式交互体验,也摊薄了单位时间成本。
- 按真实负载比,而不是按标称比。既然投机解码的收益随负载剧烈波动,「谁更快」也只有在你自己的请求分布下才有答案。用统一接入层对同一批请求打到不同供应商,实测吞吐与成功率,比抄任何一张跑分表都可靠。
- 把速度红利路由给对的场景:高吞吐的端点优先接流式、交互、长输出的任务;对延迟不敏感的批处理,则可以按价格优先。
一句话:投机解码省的是供应商的算力时间,但它省下来的红利,要靠一层会「按真实吞吐和成本动态路由」的接入层,才能真正转化成你的体验和账单优势。 这正是 LoopRouter 想做的——统一接入多家模型,持续以你自己的负载度量各家的速度、成本与可用性,把请求路由到当下最划算的那一个。
原文出处:vLLM Blog《Speculative Decoding in vLLM on AMD GPUs》 · https://vllm.ai/blog/2026-08-23-speculative-decoding-amd-gpus