本文基于 Specific Labs 公开发布的 Real-SWE 基准报告整理与二次分析,加入 LoopRouter 的选型/路由/成本视角;原始数据见文末来源链接。
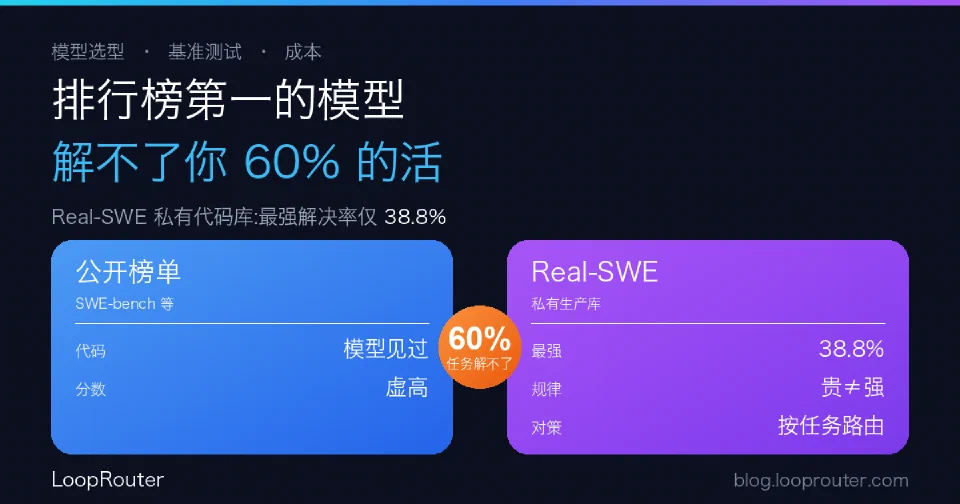
一句话结论:在真实企业私有代码库上,即便是排行榜第一的模型,也只能解决不到 40% 的工程任务;而且"更贵≠更强"。这意味着,靠一张公开排行榜、认准一个"最强模型"全量接入,几乎注定会在真实业务里翻车——正确做法是按任务类型分流,并用"每解决一个任务的成本"重新算账。
公开排行榜为什么会骗你:99% 的企业代码模型根本没见过
几乎所有主流编码基准(SWE-bench 及其衍生)都取自 GitHub 上的开源仓库。问题是:这些代码模型在训练时大概率已经见过。Specific Labs 做的 Real-SWE 换了个思路——用授权的、私有的生产代码库出题,任务直接来自计费、报税、数据迁移这类有真实业务后果的工程工作。
它给出的一个判断很刺眼:“真实企业里 99% 的 token 对前沿模型是隐藏的。” 也就是说,模型在公开榜单上的高分,很大程度建立在"见过的题"之上;一旦换成它没见过的私有代码,表现会断崖式下滑。
Real-SWE 还在两个维度刻意贴近真实工作:
- 提示更"欠定义":任务描述中位数仅 1742 字符,比 Terminal-Bench 3(1584)略长,但远没有把需求讲清楚——就像真实工单那样靠你自己补全上下文。
- 改动更"跨函数":参考答案中位数要编辑 11 个文件,而 FrontierCode、DeepSWE 只有 6 个。企业任务很少是"改一个函数"那么干净。
榜单:最强模型解决率也只有 38.8%
下面是 Real-SWE 的解决率排行(pass@1,8 次运行取平均):
| 排名 | 模型(配套工具) | 解决率 |
|---|---|---|
| 1 | Fable 5.1(Claude Code) | 38.8% |
| 2 | GPT-6 Astra(Codex CLI) | 33.8% |
| 3 | Gemini 3.8 Flash(Gemini CLI) | 31.2% |
| 4 | GLM 5.3(Claude Code) | 28.8% |
| 5 | Grok 4.6(Grok Build) | 23.8% |
| 5 | Muse Spark 1.3(Muse Code) | 23.8% |
| 7 | Kimi K3(Kimi Code) | 18.8% |
| 8 | GPT-5.6 Sol(Codex CLI) | 16.2% |
注意两点:第一,测的是"模型 + 执行工具(harness)“的组合,而不是裸模型——这本身就说明,接入方式和工具链对最终效果影响很大。第二,第一名也只有 38.8%,六成以上任务无人能解;没有任何一个模型解决了全部任务。
任务维度的分布更能说明"难在哪”:
| 任务类型 | 整体解决率 |
|---|---|
| 多区域配置扫描 | 67.2% |
| API 密钥与环境 | 65.6% |
| 超额权益计费行 | 50.0% |
| 客户身份迁移 | 40.6% |
| 计费周期迁移 | 14.1% |
| API token 计量 | 12.5% |
| S3 数据存储度量 | 10.9% |
| 线性一致性扫描 | 4.7% |
| 税务辖区 | 3.1% |
| 分析流 reducer | 0.0% |
10 个任务里有 6 个解决率低于 15%。 换句话说,模型对"读配置、填环境"这类浅层任务还行,一旦涉及业务语义深、跨系统约束强的任务(计费迁移、税务、数据一致性),基本集体失灵。
贵的不一定强:按"每解决一个任务"算账
这是对成本治理最有价值的一条发现。单次 rollout 的估算成本从 2.50 到 6.96 美元不等:
| 模型 | 单次成本 | 解决率 |
|---|---|---|
| Gemini 3.8 Flash | $2.50 | 31.2% |
| GPT-5.6 Sol | $2.65 | 16.2% |
| Muse Spark 1.3 | $2.74 | 23.8% |
| Grok 4.6 | $3.44 | 23.8% |
| Kimi K3 | $3.90 | 18.8% |
| GPT-6 Astra | $4.67 | 33.8% |
| GLM 5.3 | $5.12 | 28.8% |
| Fable 5.1 | $6.96 | 38.8% |
报告的结论直白:“更高的成本并不保证更高的解决率。” 最便宜的 Gemini 3.8 Flash(2.50 美元)解决率 31.2%,反而高过贵一倍多的 GLM 5.3(5.12 美元、28.8%)。如果你只盯着"每 token 单价"或"谁是榜一"做采购,很可能既多花钱又没买到效果。
另一个反直觉的点:慢不等于对。10 分钟以内的短 rollout 失败率 71.4%,10 分钟以上的长 rollout 失败率 73.4%——让模型"多想一会儿"并不能显著救回一个它本来就做不对的任务。
失败不是随机的:每个模型都有自己的"惯犯"模式
按 DeepSWE 的失败分类(未经验证的假设、漏需求、集成错误、回归、改错文件),“漏需求"是最普遍的失败类型,而且不同模型的短板各不相同:
- Grok 4.6:67.2% 的失败是"漏需求”——它容易只做你明说的那部分,忽略隐含约束。
- GPT-5.6 Sol:43.3% 的失败是"未经验证的假设"——它倾向于自作主张地假设,而不去核对。
- Gemini 3.8 Flash:49.1% 的失败是"集成错误"——单点逻辑对,但接入真实系统时出问题。
这对选型的启示是:不存在"全面最强",只有"在某类任务上错得更少"。 对需求边界模糊的工单,Grok 这类"漏需求"型选手风险更高;对要对接一堆外部系统(AWS、Docker、K8s、PostgreSQL、Redis、Slack……)的集成活,则要警惕"集成错误"型模型。
LoopRouter 视角:别赌一个冠军,要组一支球队
Real-SWE 把一个常被忽略的事实摆上了台面:在公开榜单上选模型,和在你自己的业务里用模型,是两回事。 对做多模型接入的团队,落地建议有四条:
- 先在自己的真实任务上做小规模实测,再决定主力模型。 公开基准只能当"门票筛选",不能当"录取通知"。把你最典型的几类工单抽样,跑几个候选模型的 pass@1,比任何榜单都可信。
- 按任务类型路由,而不是全量押一个模型。 既然浅层配置任务人人能做、深层业务任务人人都难,就该把简单任务分流给便宜模型(省钱),把高价值难任务交给榜首模型或做多模型投票,并接受"有些任务就是要人工兜底"。
- 用"每解决一个任务的成本"重写成本口径。 单价最低的模型如果解决率也低,实际是在"便宜地失败"。路由层应当按"有效产出成本"统计,而不是只看账单上的 token 数。
- 把失败模式纳入路由策略。 对需求边界模糊的任务,优先选"漏需求率低"的模型,或在提示层强制补全验收标准;对重集成的任务,增加自动化校验环节拦截"集成错误"。
这正是统一接入层(如 LoopRouter)的价值:把"选型—分流—成本核算—失败兜底"这套本该按任务做的精细活,收敛到路由层统一做对,而不是让每个业务各自盲赌一个"网红模型",然后在真实代码库里集体栽跟头。
常见问题
见页面 FAQ 区。核心提醒:Real-SWE 的绝对数值来自 Specific Labs 2026 年 9 月发布的这一版基准,模型版本与分数会随迭代变化,引用时请以原始报告为准;本文的选型方法论(自测优先、按任务路由、按有效产出算成本)则长期适用。