本文基于 arXiv 论文《What Breaks Under Pruning in Smart Homes, and When?》(arXiv:2609.17515v1,投稿 EACL 工业赛道)的公开摘要整理与二次分析,加入 LoopRouter 在 Agent 接入与模型路由上的视角;原文见文末链接。文中数字沿用来源设定,建议以你自己的任务集复测。
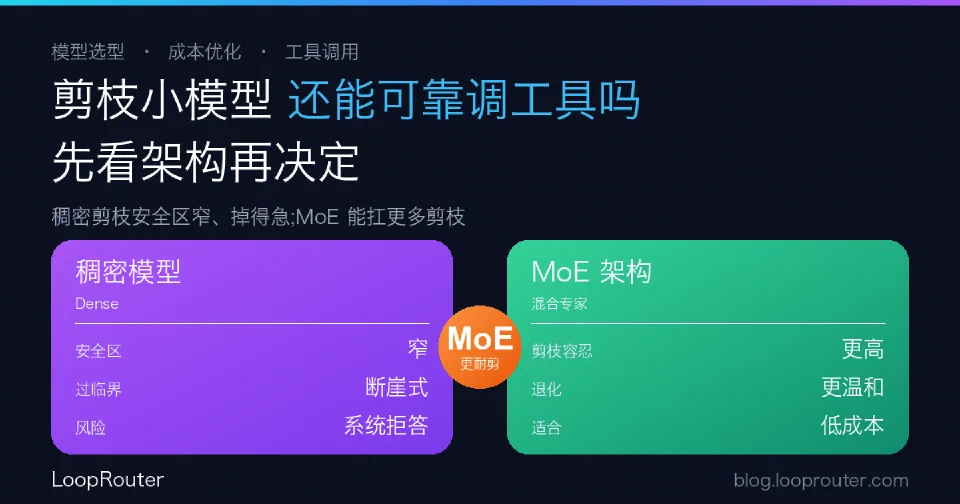
一句话结论:为了压低部署成本而剪枝的小模型,做工具调用时会先坏在最要命的地方——设备、参数、取值这些具体槽位比高层意图更早出错。一项跨 4 个模型、超过 1.95 万条实例的研究还发现:稠密模型剪枝「安全区窄、掉得急」,MoE 能扛更多剪枝;剪得太狠,模型甚至会系统性拒答。所以「用哪个剪枝档位的模型调工具」不该拍脑袋,要按架构和任务复杂度来定。
剪枝省了成本,先崩的却是「填对参数」这件事
剪枝(pruning)是压缩大模型、降低部署成本的常用手段。但它对上下文相关的工具调用到底伤在哪,一直缺乏系统评估。这项研究把工具调用拆成几个组成部分——操作(operation)、设备(device)、参数(argument)、取值(value)——分别看剪枝的影响,得到一个反直觉的结论:
剪枝先削弱「接地具体性」,再影响「结构层意图」。
翻译成人话:一个被剪过头的模型,可能大致听懂了「把客厅的灯调暗」,却把设备填成卧室、把亮度值填错。它的高层意图还在,具体槽位先坏了。这对 Agent 场景特别危险,因为工具调用的成败恰恰取决于这些具体参数对不对。
同样是剪枝,稠密模型和 MoE 的命运完全不同
研究覆盖了三类架构、4 个模型,并用四种剪枝方法(深度、宽度、混合、专家剪枝)、超过 1.95 万条实例、三个智能家居数据集做评测(剪枝后都补了监督微调 SFT)。架构之间的差异非常明显:
| 架构 | 剪枝容忍度 | 退化特征 |
|---|---|---|
| 稠密 Transformer / 稠密混合 | 低 | 安全剪枝区窄,越过临界点急剧退化(悬崖式) |
| 混合专家(MoE) | 高 | 能容忍实质上更多的剪枝 |
两点结论直接影响选型:
- 稠密模型剪枝像走钢丝:有一段能用的「安全区」,但很窄,一旦剪过头质量断崖式下跌。想靠剪枝稠密模型省钱,余量很小。
- MoE 更耐剪:因为推理时只激活部分专家,冗余更多,同样的剪枝力度下退化更温和。做低成本工具调用,MoE 的容错空间更大。
最坑的故障不是答错,而是「学会了拒绝」
除了填错参数,研究还点出一个隐蔽故障:激进的稠密剪枝会诱发「系统性过度拒答」。模型开始动不动就拒绝执行本该完成的操作。
这个信号很容易被误读成「模型更谨慎、更安全了」,实际上是能力受损的伪装。在生产里,拒答率悄悄上升往往比明目张胆的报错更难发现——用户以为是策略,其实是模型被剪坏了。所以监控工具调用时,拒答率应该和参数级准确率一起被盯住。
LoopRouter 视角:把「剪枝档位」变成一条按复杂度分流的路由规则
这项研究最实用的一点,是它给了「怎么用便宜模型」一个可操作的边界。因为退化随任务复杂度上升、且依赖架构,正好可以在统一接入层做智能路由:
- 高频、简单、容错高的工具调用(如开关灯、查状态)→ 下放到剪枝更狠的便宜模型,优先 MoE 架构,吃满成本红利。
- 高复杂度、参数敏感、失败代价高的调用(如多设备联动、带精确取值的操作)→ 路由到剪枝更轻或未剪枝的更强模型,守住参数级准确率。
- 全程监控两个指标:参数/取值级别的槽位准确率,以及拒答率;任一异常上升就把该类请求上调到更强档位。
换句话说,别用「一个剪枝档位打天下」。把模型按架构和剪枝力度分成几档,再按任务复杂度把请求路由过去——简单的交给便宜的,复杂的留给可靠的。这样既拿到剪枝省下的成本,又不会让 Agent 在关键调用上悄悄填错参数或学会拒答。