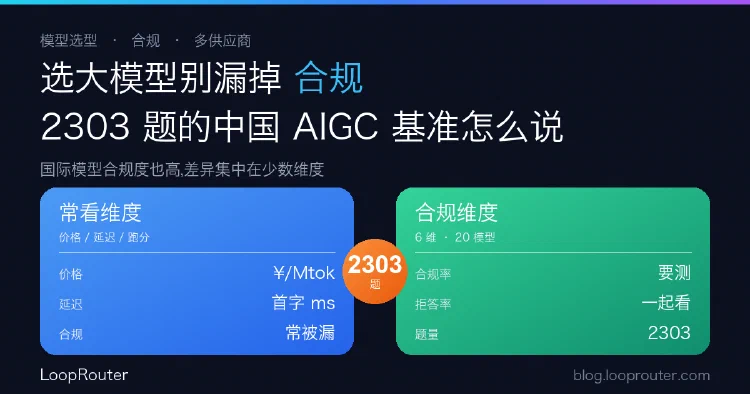
选大模型别漏掉「合规」这条维度:20 个模型的中国 AIGC 合规基准说了什么
企业选模型常盯着价格、延迟、跑分,却漏了一条硬约束:能不能过中国 AIGC 内容合规要求。一份覆盖 20 个模型、2303 道题、6 个维度的基准显示:连国际模型在标准中文问题上的合规度也很高,模型间的差异主要落在少数几个维度上。从接入与选型视角看合规该怎么纳入。
技术文档、翻译、笔记与深度文章。
企业选模型常盯着价格、延迟、跑分,却漏了一条硬约束:能不能过中国 AIGC 内容合规要求。一份覆盖 20 个模型、2303 道题、6 个维度的基准显示:连国际模型在标准中文问题上的合规度也很高,模型间的差异主要落在少数几个维度上。从接入与选型视角看合规该怎么纳入。
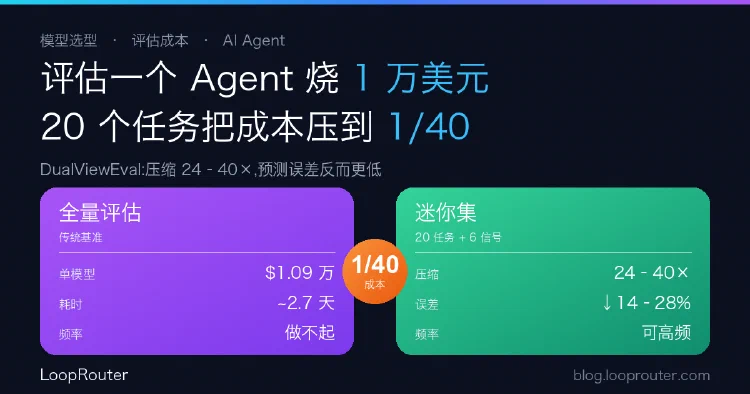
在 APEX-Agents 上评估一个前沿模型约花 1.09 万美元、跑 2.7 天,让'持续选型'贵到做不起。DualViewEval 用 20 个任务的迷你集加 6 个过程信号,把 Agent 评估压缩 24–40 倍、误差还更低。本文拆解方法,并给出 LoopRouter 的选型与路由落地视角。
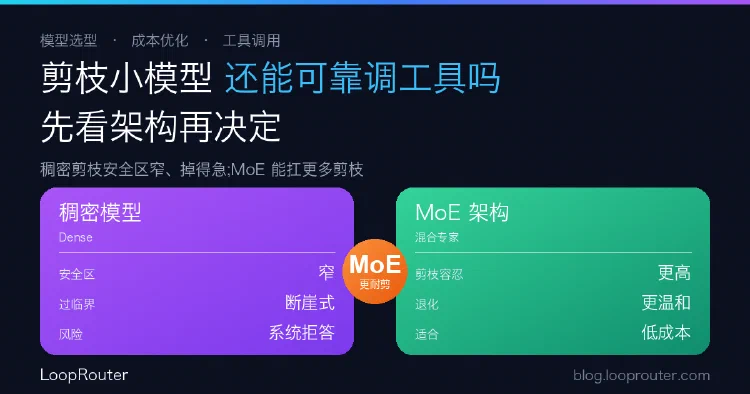
剪枝能压低大模型部署成本,却会先削弱工具调用里最具体的部分(设备、参数、取值)。一项跨 4 个模型、1.95 万条实例的研究显示:稠密模型剪枝「安全区窄、掉得急」,MoE 能扛更多剪枝;剪太狠还会让模型系统性拒答。从 Agent 接入与模型路由视角给出选型建议。
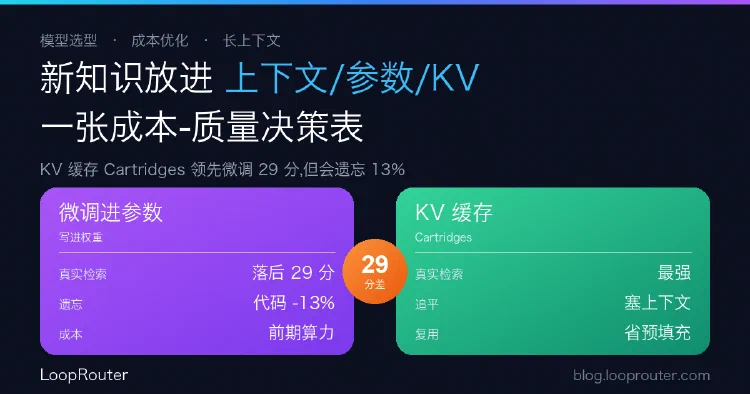
同一批文档,放进上下文窗口、微调进参数、还是编码成 KV 缓存(Cartridges/Compaction),准确率和成本差很多。一项受控对比显示:KV 缓存的 Cartridges 在真实检索场景领先微调 29 分,但会带来最高 13% 的灾难性遗忘。从企业接入与成本治理视角给出选型建议。
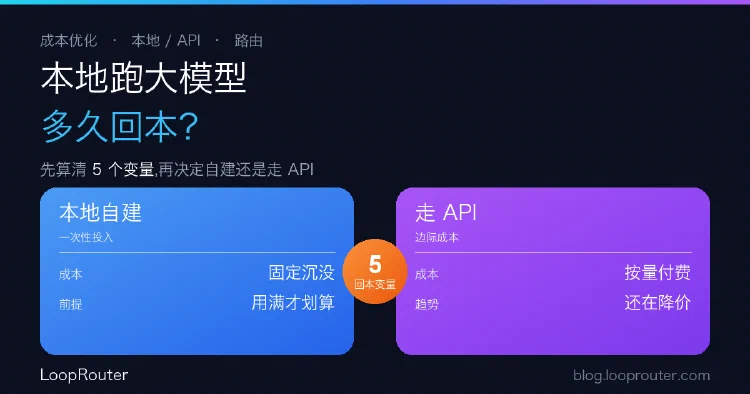
「买台机器自己跑模型」到底几个月回本,取决于日均 token 量、输入输出比、电费、API 单价,以及一个最容易被忽略的变量——API 价格还在往下掉。本文拆解这套回本测算的框架,并给出 LoopRouter 视角:多数团队的最优解不是二选一,而是本地与 API 之间按任务路由。
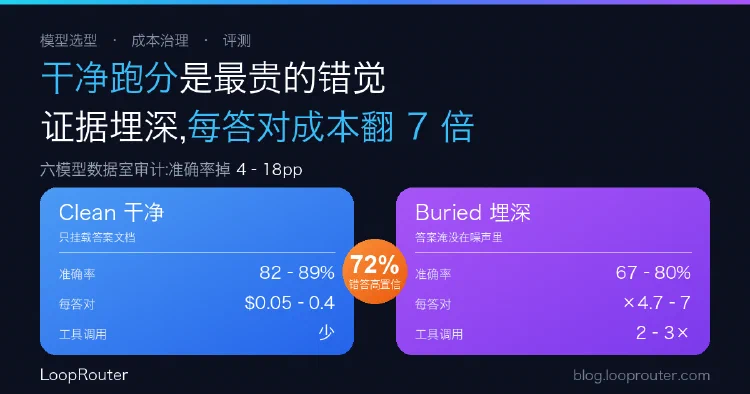
一项对六家前沿模型的「数据室审计」发现:把答案证据从干净文档挪进带噪声的真实文件堆后,准确率掉 4–18 个百分点,而每答对一题的成本涨了 4.7–7 倍。更关键的是,模型在变难时的行为分成两派——有的学会说『我不确定』,有的照样满分自信地答错。这决定了你该怎么路由与选型。