本文基于独立开发者 Mo Moustafa 的公开实测文章(2026-09-07,经 Simon Willison 转述而进入视野)整理与二次分析,加入 LoopRouter 在多模型接入、成本治理与路由策略上的视角;文中数据沿用原文实测口径,原文见文末链接。
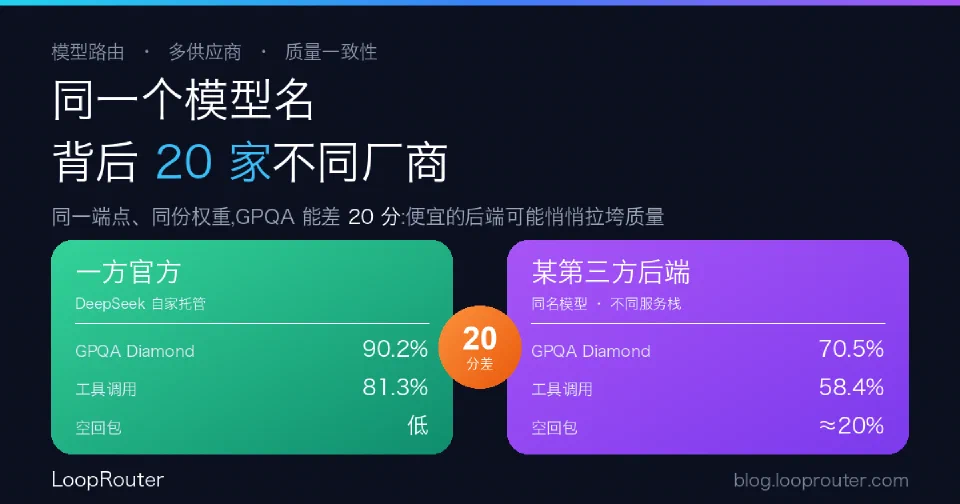
一句话结论:当你调用 deepseek/deepseek-v4-flash 这样一个模型名时,聚合路由(如 OpenRouter)背后可能把请求发给近 20 家不同厂商——它们跑的是同一份权重,却是「纸面上同一个模型,现实里完全不同的模型」。实测中,同一模型在一线官方厂商和某些第三方后端之间,GPQA Diamond 能差 20 个百分点;还会撞上视觉失明、reasoning 参数被静默忽略、20% 请求返回空回包等坑。「统一一个端点、自动挑最便宜的后端」很省心,但省下的钱可能被质量塌方和可用性事故吃回去。
一个模型名,为什么会变成 20 个不同的模型
先厘清一组常被混淆的概念:
- 模型(model) = 权重。DeepSeek V4 Flash 就是那一份参数。
- 厂商(provider) = 谁在自己的 GPU 上、用什么精度、配什么推理引擎和解析器把这份权重跑起来。
聚合路由的卖点,是给你一个模型名,它自动路由到「当下最便宜/最可用」的那家厂商。问题在于:同一个 deepseek/deepseek-v4-flash 背后挂着约 20 家公司,每家的服务栈都不一样。于是同一个端点、同一段请求,可能被随机发到质量天差地别的后端——而你在代码里看到的模型名,一个字都没变。
差距有多大:同名模型的基准分能差 20 分
原文作者运营一款跑在开源模型上的 iMessage 助手,累计处理超过 1800 万条消息,其中约三分之一走开源模型。他用 GPQA Diamond 和 TAU-Bench Airline 两项基准,对 DeepSeek V4 Flash 的不同后端做了 32 天滚动实测:
| 后端厂商 | GPQA Diamond | TAU-Bench(工具调用) |
|---|---|---|
| DeepSeek 官方(一方) | 90.2% | 81.3% |
| Nebius | 75.6% | 65.3% |
| DigitalOcean | 75.3% | 58.4% |
| OpenInference | 70.5% | 70.8% |
| Sail Research | 70.8% | — |
同一份权重,GPQA 从 90.2% 掉到 70.5%,近 20 个百分点的落差;大多数第三方在工具调用上比一方低 5~7 分。作者强调这「不是噪声」。而在更早的 7 月,某后端在 TAU-Bench 上只拿到 46%,与一方拉开了 30 分的鸿沟。
对企业来说,这意味着:你以为在用「同一个模型」做 A/B 或成本优化,实际上后端一换,业务指标就悄悄塌了一截,而监控里模型名纹丝不动。
三个「看起来支持、其实不支持」的能力陷阱
比分数差异更隐蔽的,是能力层面的「假支持」——后端声称支持某能力,却在真实调用里翻车,且往往不报错。
1)视觉:有的后端根本「看不见图」。 对小图做识别测试时,某后端把红色说成蓝色、把字母 K 读成 R;更极端的是,有两家后端对图片直接返回「no image provided」——它们其实没有视觉能力,却在模型页面上被标为支持,并且「假装一切 200 OK」。
2)reasoning 参数被静默忽略。 reasoning.effort 这个控制思考强度的参数,几乎所有后端都「接受」,但实测中有 4 家(digitalocean、gmi-cloud、mancer、venice)完全不生效——你以为开了高强度推理,其实什么都没发生。建议按后端逐一核对 reasoning token 的实际消耗。
3)工具调用/结构化输出解析漏网。 部分后端的解析器会把工具调用的原始标记直接当成回复吐出来(例如把 <use_skills>... 的 XML 泄漏到正文),复现率「因厂商而异」。
比报错更麻烦的:HTTP 200 的「空回包」
真正的运维噩梦不是明确的错误,而是表面成功、实则无内容的响应:
- 推理黑洞:推理模型有时把所有内容都塞进 reasoning,
content返回null、finish_reason却是stop。原文举例:消耗了 345 个 completion token、HTTP 200,却没有一个字可用。处理原则:没内容又没工具调用,就当失败,抛出并重试。 - hollow completion(空壳回包):200 状态、content 为 null、reasoning 为 null、连
usage计费对象都没有。某后端在 7 月的 DeepSeek 流量里,约 20% 命中这种空壳,占其空回包的 92%;一个月后另一家在同一 checkpoint 上重演了同样的问题。
这类响应在监控里是「成功请求」,却对用户毫无价值——如果你的重试逻辑只认 4xx/5xx,就会漏掉一大片实际失败。
「精度过滤」是个伪解法
一个自然的念头是:那我按精度筛,只用 fp8 不用 fp4,总该稳了吧?实测给出反直觉的结论:
- fp4 的后端成绩,落在 fp8 那一堆的中间;
- 某模型 GPQA 最差的三名里,fp8、fp4、未声明精度各占一个;
- 另一个模型上,两项基准都拿第一的后端,精度栏「什么都没声明」。
结论很直接:精度位宽是很差的质量代理指标。而且硬过滤精度还有副作用——可用后端池被缩小,故障切换时反而更容易无路可走。作者的原话是:「按榜单选,别按位宽选。」
锁死「靠谱厂商」为什么会全线崩
那反过来,干脆只锁定几家高质量厂商、关掉自动 fallback,是否就稳了?一个真实翻车案例:
作者把某热门模型固定为 provider.order: [cloudflare, baidu, alibaba] 并设 allow_fallbacks: false。两周后——Baidu 开始全量 429,Cloudflare 干脆不再提供这个模型,于是 100% 流量压到 Alibaba,紧接着 Alibaba 也开始 429。排名第一的模型,锁定到三家「可靠」后端,整体宕机,把上层业务一起拖下水。
这揭示了一个核心张力:一致性(锁定高质量后端)和可用性(保留足够切换余量)是一对需要同时治理的矛盾,任何一端做绝都会出事。此外还有隐蔽的「测试即生产」陷阱:某两家后端从作者的 Mac 上能正常调用,从生产基础设施发起却几乎每次 429——同一把 key、同一分钟——读作 IP 维度限流。所以压测必须从生产真正所在的网络环境发起,样本量要比「感觉够了」再多一些。
从 LoopRouter 视角看:路由不是「挑最便宜」,而是「按质量与可用性联合治理」
上面这些坑,本质上都指向同一件事:把多模型/多厂商的复杂度全交给一个「自动挑便宜」的黑盒,是在用可观测性和质量一致性换省事。 对严肃的企业接入,值得把路由当成一层需要主动治理的能力,而不是甩手掌柜:
- 按真实业务基准选后端,并持续监控漂移:用你自己的评测集给候选后端打分,而不是信厂商宣传或精度标签;质量会随时间漂移,得常态化监控。
- 能力逐后端验证,而非信「模型页面」:视觉、reasoning、工具调用这类能力,要对每个实际会命中的后端单独验证,别假设「模型支持 = 每家后端都支持」。
- 把「空成功」纳入失败判定:200 + 空 content、hollow completion 都要当失败重试,监控口径不能只看 HTTP 状态码。
- 可用性靠多样化冗余,而非少数明星:既要限定高质量后端集合,又要保留足够宽的切换路径,并配指数退避与抖动,避免锁死几家后一起崩。
- 成本要算「有效成本」:最便宜的后端如果质量塌方、空回包频发、还得重试,单价再低也是负优化——真正该优化的是「每个可用结果的成本」,不是「每次请求的标价」。
聚合路由降低了「接入很多模型」的门槛,这是好事;但它没有消除「不同后端质量不一」的物理现实,只是把这份复杂度藏了起来。企业要做的,是把它重新显性化、可度量、可治理——这正是一个成熟模型路由层该干的事。
原文来源:Mo Moustafa,《So you want to use OpenRouter?》(2026-09-07),见文末 source 链接。文中基准数值、后端厂商名与故障案例均沿用原文实测口径,具体数字会随时间与 checkpoint 变化,接入前建议以你自己的评测复核。