本文基于 Hacker News 高热讨论(334 分、527 评论)整理与二次分析,加入 LoopRouter 的路由/故障切换视角;原帖见文末来源链接。文中已区分"已证实"与"推测"。
一句话结论:2026 年 9 月 3 日上午美东时间,ChatGPT、Claude、Grok 相继大面积报错,唯一接近实锤的根因是 xAI 孟菲斯算力中心故障;而这次事件最值得企业记住的教训是——配置雷同、缺乏退避的自动 failover,本身就可能是把故障从一家传染到全行业的放大器。
时间线:一小时内三家相继倒下
根据讨论中引述的报道与用户观察(时间均为美东时间):
| 时间 | 事件 |
|---|---|
| ~9:00 | Grok 与 Claude 的故障报告开始上升 |
| ~9:40 | Anthropic 侧错误量激增,Claude Code 与 Chat 受影响最重,报"容量受限"类错误 |
| ~10:30 | OpenAI 故障报告上升,ChatGPT/Codex 受影响,含语音模式与登录组件 |
| 当天内 | ChatGPT 与 Claude 的故障均标记为已解决 |
下游工具同样受灾:Cursor 报错;有用户观察到 Claude Code 以 4 分钟间隔重试、20 分钟后放弃。Gemini 是主要例外——多数用户反馈全程可用,仅个别用户报告错误。
已证实的信息只有两条
五百多条评论里,能算"官方说法"的只有:
- xAI 公开致歉,承认当天上午孟菲斯算力中心发生故障,并向"受影响的算力合作方"致歉。这是全场唯一接近实锤的根因线索,“算力合作方"的措辞也引发了谁在租用其算力的猜测(有评论称 Anthropic 租用了 xAI 的推理算力,但此说法未经证实)。
- Cloudflare CTO 明确否认是 Cloudflare 的问题。
其余一切都是推测。
社区四大假说,按热度排序
- 级联过载(最热门):一家先倒,用户与自动切换工具涌向其他家。GPU 推理容量普遍余量极小,多接一波流量就可能被压垮——不需要共用任何基础设施,用户行为本身就是传导介质。
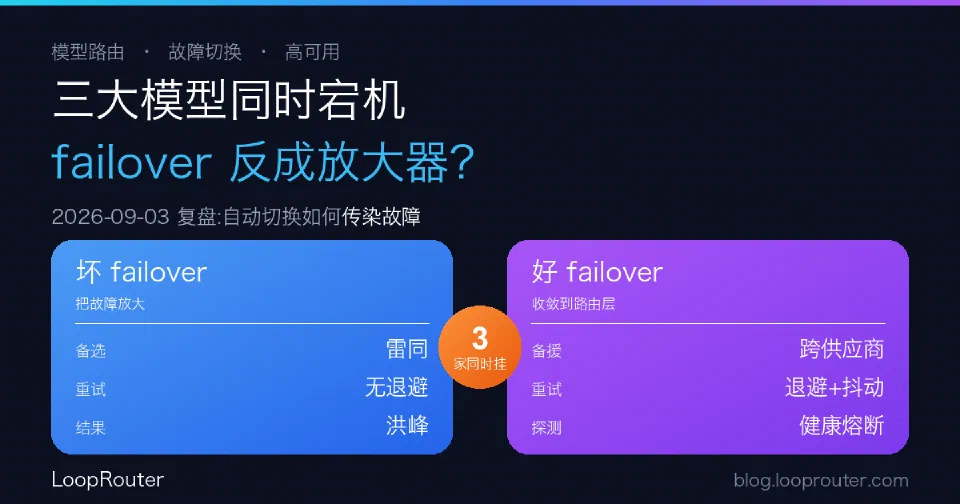
- 自动 failover 放大:Cursor、Copilot 等工具会机器级自动切换备用模型,比人工迁移快得多;有评论指出不少编码工具的重试逻辑缺乏指数退避。还有人引用负载均衡领域的 Power of Two Choices 研究提醒:如果所有人的备选列表都一样,“切换"这个动作本身就是同步的压力洪峰。
- 共同底层依赖:Cloudflare、AWS、光纤骨干、DNS、BGP 等。但除了被 CTO 否认的 Cloudflare,没有任何一条被证实。
- 纯属巧合:各家本就时常故障,时间迟早重叠。
别急着截图 Downdetector
讨论里的一条高赞提醒值得单独拎出来:有用户看到 Downdetector 上 Cloudflare、Azure、AWS、Google Cloud 的报错量"同时上升”,看起来像全网瘫痪的铁证。
但 Downdetector 没有任何主动探测能力,数据完全来自用户点击"报告问题"的次数与历史基线的对比。大范围故障发生时,用户会恐慌性地检查并报告一切服务——四大云商"同时报错"很可能只是集体焦虑的投影,而非四家真的都出了问题。把它当作用户情绪指标可以,当作故障证据不行。
LoopRouter 视角:failover 不是"配个备选列表"就完事
这次事件对做多模型接入的团队,教训比结论更清晰:
- 备援要跨供应商,更要跨底层算力。 xAI 向"算力合作方"致歉这个细节说明,表面上不同品牌的 API 底层可能共享算力来源。做冗余设计时,值得搞清楚你的主备两条路径是否真的物理隔离,避免"假冗余”。
- 重试必须带指数退避和抖动。 Claude Code 那种固定 4 分钟间隔的重试已经算克制的;更糟的是海量客户端以相同节奏同时重试,等于给恢复中的服务持续补刀。
- 备选列表要有多样性。 如果整个行业的工具都配"A 挂了切 B",那么 A 的故障就是 B 的压力测试。路由层可以通过加权随机、分批放量等方式打散切换洪峰,而不是让所有流量瞬间涌向同一个目的地。
- 健康探测 + 熔断优于被动重试。 路由层主动探测各供应商健康度,提前把流量从劣化的端点上移走,比等请求超时后再切换体验好得多。
对使用 LoopRouter 这类统一接入层的团队,这正是网关存在的意义:把退避、熔断、跨供应商分流这些容易被单个应用忽略的细节,收敛到路由层统一做对——而不是让每个客户端各自为战,在下一次行业级故障里再当一次放大器。
常见问题
见页面 FAQ 区。核心提醒:本次事件截至讨论时没有统一官方定论,引用本文时请区分 xAI 已承认的算力中心故障(事实)与级联过载等假说(推测)。