本文基于 OpenAI 官方开发者文档(Agents API Overview)整理与二次分析,加入 LoopRouter 的多模型接入与成本治理视角;原文见文末来源链接。
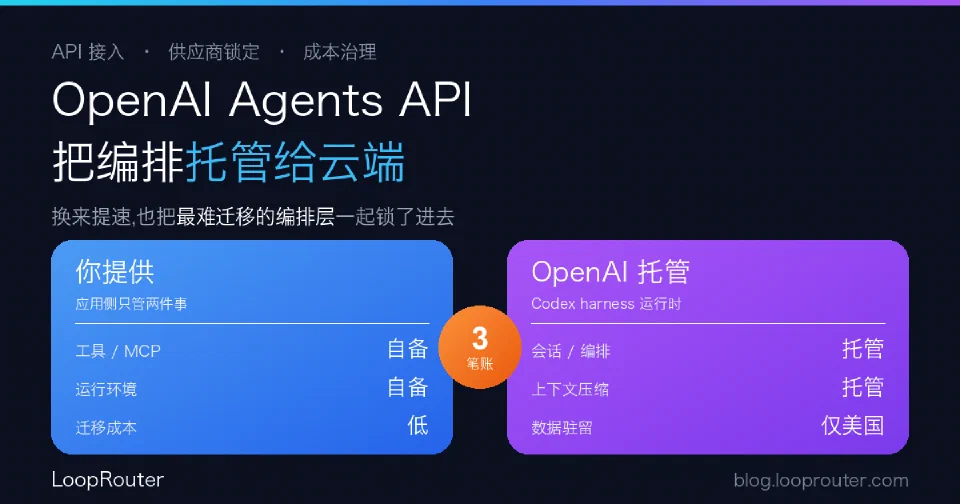
一句话结论:OpenAI 的 Agents API 把过去要自己写的会话管理、编排、上下文压缩和断点恢复整套托管到云端,应用只需提供工具和运行环境——它换来了开发提速,但也把最难迁移的编排层、以及"仅美国驻留、不支持 ZDR"两条硬约束一起打包塞了进来。接入前要先算清三笔账:锁定成本、合规成本、容器计时成本。
Agents API 到底托管了什么?
它对外提供的是对 Codex harness 的应用级访问。换句话说,OpenAI 把驱动 Codex 的那套运行时开放出来,由官方托管四件事:会话(session)、编排(orchestration)、上下文压缩(context compaction)、失败恢复(recovery)。你的应用负责两件事:提供工具/MCP 服务器,以及选择执行环境。
托管运行时能力包括:
- 在沙盒里运行命令与代码、改文件、产出制品(artifacts)
- 应用 skills 与 instructions
- 通过工具或 MCP 连接外部数据
- 运行中途"steering"(人为纠偏)
- 自动总结既往工作以管理上下文窗口
- 把子任务委派给子代理
- 从断点恢复会话
四个核心概念
理解 Agents API 只需记住四个对象:
| 概念 | 含义 |
|---|---|
| Agent | 模型 + 指令 + 工具 + MCP 服务器的组合 |
| Environment | 可选的沙盒/计算环境,承载文件、skills、命令 |
| Session | “一个持久的 agent 实例,持续处理任务并响应输入” |
| Events & items | 会话过程中发送的输入与产生的输出 |
会话生命周期是四步:创建会话(OpenAI 自动 provision 环境)→ 下发任务(开启一个 turn)→ 用流式或 webhook 跟进 → 继续或 steering。会话状态被保留,后续 turn 无需重建对话上下文。
一个最小请求长什么样
用 client.beta.agents.sessions.create()(或 POST /v1/agents/sessions),需带请求头 OpenAI-Beta: agents=v1。示例里出现的关键参数:
agent.model:如gpt-6-astraagent.tools:如programmatic_tool_calling、mcp(需server_label+transport.type: http+server_url)、web_searchagent.multi_agent:{ enabled: true, max_concurrent_subagents: 4 }environment.type:self_hosted(也提供 OpenAI 托管沙盒);workspace_directory: "/workspace"input:role/content 消息数组(input_text)
两条必须先过的硬约束
在写第一行接入代码前,先确认这两点是否卡住你的场景:
- 数据驻留只支持美国。 有数据出境/本地化合规要求的团队直接受限。
- 不支持 ZDR(零数据保留)。 官方特别强调:用自托管沙盒也不会让 Agents API 变成 ZDR 合规。这条常被误解,务必看清。
从 LoopRouter 视角:托管越多,迁移越难
Agents API 的价值主张是"少写代码":会话、编排、上下文管理这些最烦的活儿由官方兜底。但从多模型接入和成本治理的角度,它也放大了两个老问题:
- 供应商锁定上移了一层。 过去锁定发生在"模型"这一层,换模型相对容易;现在会话状态、编排逻辑、子代理调度都托管在 OpenAI 的运行时里,这一层一旦依赖,迁移成本远高于换个模型 endpoint。
- 成本结构变复杂。 账单从"按 token"变成"token + 内置工具 + 沙盒容器时长"三块叠加。长会话、多子代理并发场景下,容器计时和并发子代理的 token 消耗都需要单独监控,否则很容易在"省心"的表象下超支。
落地建议: 如果你的目标是跨供应商统一接入、做路由与成本治理,更稳妥的姿势是自己掌握编排与路由层,把 Agents API 当作可替换的执行后端之一,而不是把整条编排链绑死在单一厂商的托管运行时上。这样既能吃到托管能力,又保留了在成本、可用性、合规变化时切换的余地——这也正是模型路由层存在的意义。
来源
- OpenAI Agents API — Overview:https://developers.openai.com/api/docs/guides/agents-api/overview