本文基于 arXiv 论文《On-Demand Attention: Language Models Know When to Recall》(2026-09-17 提交)的公开摘要整理与二次分析,加入 LoopRouter 的接入/成本视角;原文见文末链接。文中不含摘要之外的量化数字,具体收益请以完整论文与自有负载复测为准。
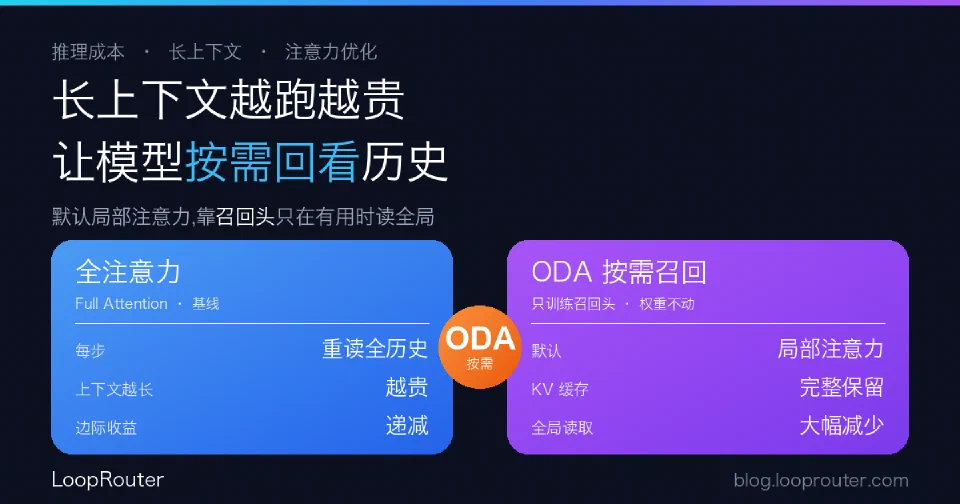
一句话结论:长上下文和 Agent 推理越跑越贵,一个被忽视的根因是——全注意力(full attention)每生成一个 token 都要重读一遍不断变长的历史,哪怕这次根本用不上。arXiv 新论文提出的 On-Demand Attention(ODA)换了个思路:默认只用局部注意力,靠一个轻量的「召回头(recall head)」预测「这一步到底要不要回看全局」,只在有用时才触发全局读取。它只训练召回头、不动预训练权重、完整历史 KV 缓存照留,在 Qwen 和 Gemma 上「基本补回了纯局部注意力丢掉的效果,同时大幅减少全局读取次数」。对只做 API 接入的团队,这不是要你自己改推理,而是提醒你:同一档模型、同样的长上下文,不同供应商的「每 token 成本/延迟」会因为这类优化而拉开差距。
长上下文为什么是成本黑洞:每一步都在重读整段历史
大模型逐个生成 token 时,标准的全注意力解码会在每一步都把已经生成的全部历史(KV 缓存)重新读一遍,再决定下一个 token。上下文越长,这份历史越大,单步读取的开销就越重——而且它随生成步数持续累加。
问题在于:这份「每步都重读全局」的开销,很多时候并没有换来更好的预测。 论文的出发点正是这一点——推理和 Agent 类负载天生就是长上下文(长文档、长链推理、多轮工具调用),于是「无差别重读历史」成了长上下文推理最直接的成本来源之一。
一句话:贵的不只是模型本身,还有在长历史上反复做的、边际收益递减的全局读取。
ODA 的核心:默认局部,按需召回全局
ODA(On-Demand Attention)是一种「局部优先(local-first)」的解码方法,思路可以拆成三步:
- 默认只看局部。 大部分解码步不去读整段历史,只用局部注意力,先把最便宜的路径走通。
- 用『召回头』预测要不要回看。 论文的关键发现是:模型在做全局读取之前,它的解码状态里就已经藏着「这次回看历史值不值」的信息。ODA 训练一个轻量的召回头(recall head)来读出这个信号。
- 只在有用时触发全局读取。 当召回头预测「这一步回看全局收益高」时,才真正调用全局注意力;收益低就跳过。触发与否随生成过程动态变化。
最省事的一点是它的「加装」姿态:ODA 只训练召回头,预训练权重保持不变,完整的历史 KV 缓存也全部保留。也就是说,它不是重训一个新模型,而是给现成模型加了一层「要不要回看」的决策开关。
它和「砍历史」的稀疏注意力,不是一回事
一提到「减少全局读取」,很容易联想到局部/稀疏注意力或 KV 缓存驱逐(cache eviction)——但那些方法通常是永久性地丢掉一部分历史:砍掉了、删掉了,后面就算需要也回不来。
ODA 的差别在于「可回收」:
| 维度 | 纯局部 / 缓存驱逐 | On-Demand Attention |
|---|---|---|
| 历史处理 | 直接裁剪或删除远处历史 | 完整 KV 缓存始终保留 |
| 全局读取 | 要么全读、要么读不到 | 按需触发,可随时召回 |
| 决策依据 | 固定规则(窗口/位置) | 召回头对「本步收益」的预测 |
| 代价 | 丢信息换速度,精度可能掉 | 用轻量预测头换「少读又不丢」 |
正因为历史没被丢,ODA 才能「基本补回纯局部注意力丢掉的效果」——它省的是没必要的重复读取,而不是省掉信息本身。
落地信号:在 vLLM 里做 GPU 端条件执行
一个技术方法能不能真省钱,关键看「少算」能不能变成「真快」。ODA 在这点上给了具体落地证据:
- 工程实现:作者在 vLLM 里实现了 GPU 端的条件执行(conditional execution),把「少做几次全局读取」在长上下文下转成真实的解码加速,而不只是理论上的 FLOPs 下降。
- 验证范围:在 Qwen 和 Gemma 系列上测试,包括混合注意力(hybrid-attention)骨干。
- 效果结论(定性):选择性召回「基本补回了纯局部注意力损失的效果,同时大幅减少全局读取次数」。
需要诚实说明的是:论文摘要没有给出统一的加速倍数、省钱百分比或具体基准分数(完整论文 28 页、5 张图,细节在正文里)。所以别把它当成「一开就省 X%」的通用结论——收益取决于上下文长度、负载类型和召回触发频率,真实数字要看完整论文,并在自己的负载上复测。
对做 API 接入的团队意味着什么
如果你不自建推理、只通过 API 用模型,ODA 这类工作不需要你亲自实现,但它改变了一件事的判断方式:长上下文场景下,「同一档模型」在不同供应商那里的性价比可能并不一样。
给接入 / 路由层的三点实操建议:
- 把长上下文单独看待。 短提示和长上下文(长文档问答、长链推理、Agent 多轮)的成本曲线完全不同。真正拉开供应商差距的,往往是后者——因为长上下文正是这类推理优化收益最大的地方。
- 把「长上下文优化」当成比价维度。 选型时除了看标价,还值得关注:谁在长上下文推理上做了 ODA 这类优化、在长输入下的实际延迟和吞吐如何。同一模型不同后端,长上下文的「每 token 成本/延迟」可能差出一截。
- 让路由按上下文长度分流。 短请求走成本最优的通道,长上下文请求走「长历史更省、更稳」的通道——把这种差异变成路由规则,而不是全都发给同一个后端。这正是 LoopRouter 这类统一接入层应该替你抹平的复杂度:你写一次调用,由接入层根据请求特征选到当下最划算、最稳的那条路。
落地一句话:ODA 提醒我们,长上下文推理的成本不是一个固定标价,而是随「历史读了多少次」浮动的变量;对接入方来说,与其自己折腾推理,不如把「长上下文场景下谁更省、更稳」纳入路由与比价的常规维度。
原文:On-Demand Attention: Language Models Know When to Recall(arXiv,2026-09-17)。本文为基于公开摘要的原创整理与分析,非原文翻译。