本文基于公开的本地模型回本测算工具 Sunk Cost(sunkcost.ai)所采用的测算框架整理与二次分析,加入 LoopRouter 在本地/API 混合接入、成本治理与路由上的视角;原文见文末链接。文中出现的具体数字均为说明性示例假设,用于演示算法,并非来自原工具的实测结果——请代入你自己的真实用量测算。
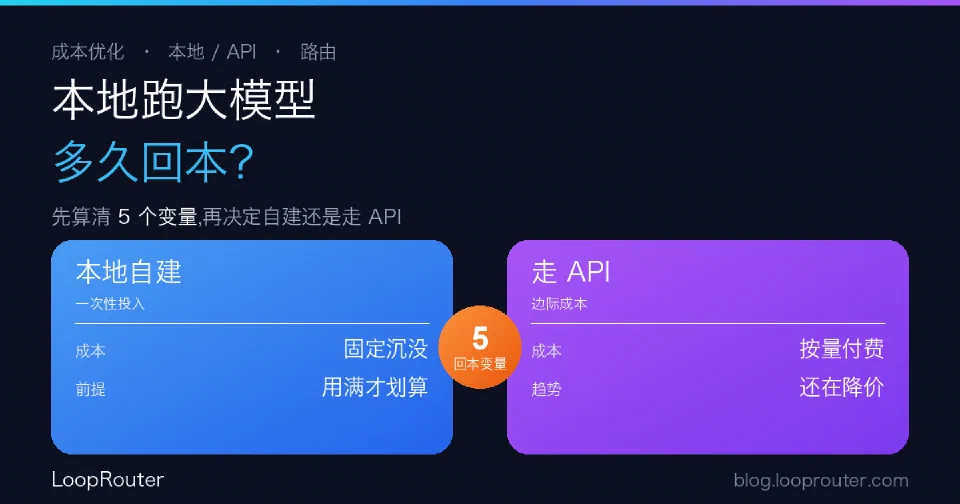
一句话结论:「买机器自己跑模型多久回本」不是一个玄学问题,它由五个变量决定——硬件一次性投入、日均 token 量、输入输出比、电费、以及你能替代掉的那部分 API 单价。而最容易被忽略、也最能推翻结论的第六个变量是:API 价格还在往下掉。算清这几项,多数团队会发现最优解不是「自建 vs 采购」的二选一,而是在本地与 API 之间按任务路由。
回本的核心公式:一次性投入,除以每天省下的钱
抛开细节,本地自建回本的骨架很简单:
回本天数 ≈ 硬件价 ÷(每天原本要付的 API 费 − 每天的电费)
分子是你的沉没成本(机器),分母是「本地跑起来后,每天净省下多少」。这也解释了为什么用量是决定性的:分母越大、回本越快。日均 token 量小而零散的团队,分母接近于零,机器大部分时间在闲置折旧,回本时间可能趋于无限。
一套完整的测算需要这几类输入:
- 硬件:机型 + 显存/内存容量 + 购置价;
- 用量:主要用途、日均 token 量、需要的上下文窗口、以及输入:输出 token 比(输入便宜、输出贵,这个比值直接影响你原本的 API 账单);
- 可调假设:电费($/kWh)、API 速度(tok/s)、以及是否**「假设 API 价格继续下滑」并设一个下滑速率**。
一个说明性示例:同样的机器,用量差 5 倍,结论完全相反
下面的数字全部是演示用的假设,不是任何实测——目的是展示同一台机器在不同用量下如何走向相反结论。假设一台机器 $6,000,电费每天忽略为小额:
| 场景 | 日均可替代的 API 费(假设) | 回本估算 |
|---|---|---|
| 轻度、零散使用 | ~$3 / 天 | 约 2000 天(≈5.5 年,基本回不来) |
| 中度、稳定管线 | ~$20 / 天 | 约 300 天(≈10 个月) |
| 重度、满负荷批处理 | ~$60 / 天 | 约 100 天(≈3.3 个月) |
同一台机器,回本时间从「三个月」到「永不」——决定权不在机器,在你能否把它喂满。这也是为什么「买了旗舰显卡结果吃灰」是本地自建最常见的亏损方式。
最容易翻盘的变量:API 价格一直在往下掉
前面的测算有一个静态假设:API 单价不变。现实里它一直在降。这意味着:
- 你今天按当前单价算出「10 个月回本」;
- 但如果这 10 个月里 API 单价掉了一半,你「每天省下的钱」(分母)也随之腰斩,回本时间会被显著拉长;
- 你追赶的那条线一直在下移——本地硬件是固定的沉没成本,而 API 是持续下降的边际成本。
所以任何严肃的回本测算,都该把「假设 API 价格继续下滑 X%/年」当成一个必填参数,而不是拿今天的单价刻舟求剑。
顺带一提速度:本地生成速度在没实测时可粗估为「显存带宽 ÷ 每 token 读取字节数」,但速度影响的是体验、不是回本——回本算的是钱,速度决定你愿不愿意用它。
能力也要分任务算:本地够用的活,和必须走 API 的活
回本只是成本侧,另一侧是能力。开源本地模型的能力评估往往「粗颗粒、按公开基准对标 GPT/Claude」——务实的读法是按任务分层:
- 本地往往够用:摘要、分类、抽取、格式化、固定提示词的批处理——高频、结果可控、对质量不极端敏感;
- 建议留给 API:最吃深层推理的规划、架构决策、复杂 Agent 编排——低频、高危、要能力上限。
把「能力够不够」和「回本快不快」放在一起看,你会发现二选一是个伪命题:回本快的恰恰是高频任务,而高频任务里很大一部分本地就能胜任。
LoopRouter 视角:别赌「自建 vs 采购」,让本地与 API 同台
多数团队真正的最优解,不是把预算 all-in 到本地机房,也不是永远只付 API,而是让两者挂在同一个接入层上,按任务、成本和负载去路由:
- 用「回本快 + 本地够用」圈定本地承载的任务面。把高频、可控、质量不极端敏感的请求默认路由到本地——这里边际成本最低、回本最快;把低频高危、要最强推理的请求路由到 API。
- 把 API 当作本地的弹性与兜底。本地机器容量有限:流量突增、或本地服务故障时,统一网关能自动故障切换到 API,而不是让业务停摆。这让你敢于按「平均负载」而非「峰值负载」配置本地硬件,进一步改善回本。
- 把回本测算做成持续的成本治理,而不是一次性拍板。API 价格在降、你的用量在变、新的开源模型在出——路由规则应该定期用真实账单复算:哪些任务现在走本地更划算、哪些因为 API 降价已经不值得自建了。统一接入的意义,就是让这种「随时切换」几乎零成本。
落地一句话:「本地多久回本」的答案,写在你的日均 token 量和输入输出比里,而不是机器的标价上;而一旦把 API 还在降价、以及本地能力只覆盖部分任务这两件事算进去,结论几乎总是——不要二选一,让本地与 API 挂在同一个网关上按任务路由、互为弹性与兜底,才是把这笔账长期算对的方式。