本文基于 arXiv 论文《An Analysis of Training-Free Self-Reported Confidence in Language Models》(arXiv:2609.20541v1)的公开摘要整理与二次分析,加入 LoopRouter 在模型路由与成本治理上的视角;原文见文末链接。文中数字沿用来源设定,建议以你自己的任务集复测。
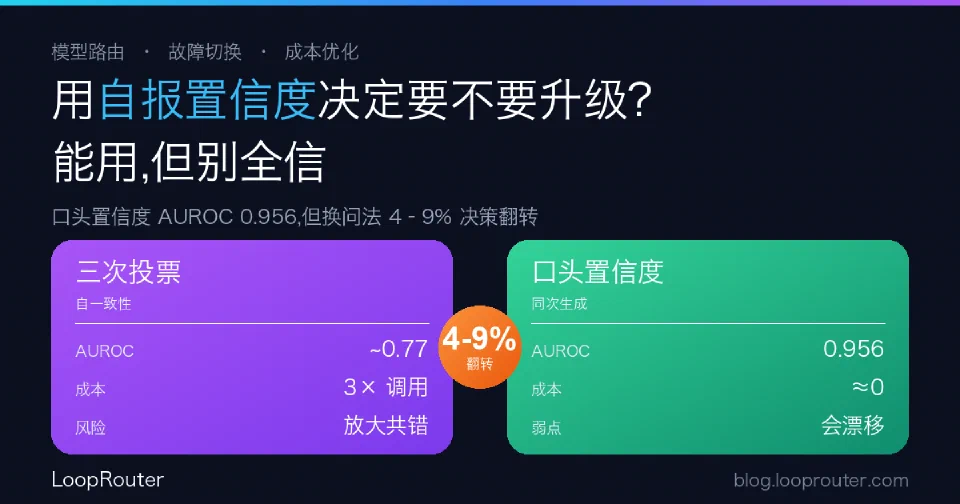
一句话结论:想用模型「自己报的置信度」来决定「这条查询要不要升级到更强、更贵的模型」——这条路能走,但要小心。一份受控测试发现:让模型直接把置信度和答案一起说出来,预测对错的 AUROC 高达 0.956,比跑三次投票取一致性(约 0.77)强得多、还便宜;但它很脆——只是换个等价问法,就有 4%–9% 的升级决策会翻转。置信度可以当路由的第一道门控,但别把它当成能一劳永逸的开关。
为什么「让模型自己报置信度」是个路由问题?
在多模型接入里,最省钱的策略往往是分级路由:简单查询先走便宜的小模型,拿不准的再升级(escalate)到更强、更贵的模型或做兜底。这里的关键零件,就是一个「拿不准」的判据。
模型自己报的置信度,是最诱人的那个判据——不用额外训练、不用外挂打分器,让模型输出答案时顺手说一句「我有多确定」就行。问题只有一个:这个自报的数字,到底是真的校准过,还是只是嘴上说说? 这篇论文正是冲着这个问题去的,而它的答案直接决定了「置信度路由」值不值得建。
三种免训练置信度信号,谁最准?
论文对比了三种不需要额外训练就能拿到的置信度信号,用它们预测「这次答对了没有」,在 100 道 TriviaQA 问答题、两个模型家族上测 AUROC(越接近 1 越能区分对错):
| 置信度信号 | 怎么拿 | 预测对错的 AUROC(两个模型家族) | 额外成本 |
|---|---|---|---|
| 口头置信度(verbalized) | 让模型答题时直接说出置信度 | 0.956 / 0.937 | 几乎为零(同一次生成) |
| 事后 P(True) | 再问模型一次「上面的答案对吗」 | 介于两者之间 | 多一次调用 |
| 三次采样一致性(3-sample) | 同题采样 3 次,看答案是否一致 | 0.765 / 0.790 | 多 3 倍调用 |
结论很反直觉:最便宜的信号反而最准。让模型答题时顺口报的置信度,区分对错的能力(AUROC ~0.95)明显强过「多花 3 倍算力去投票」的自一致性(~0.77)。把自一致性和口头置信度做固定加权融合,也没有带来统计上可靠的提升——多花的钱没换来更准的路由。
便宜的信号也脆弱:换个问法,4%–9% 的决策就翻了
如果故事到这里结束,那置信度路由就是稳赚。但论文的第二个发现是泼冷水的:口头置信度对「怎么问」高度敏感。
研究者对同一批已经固定的答案,用意思等价、只是措辞不同的提示词重新索取一次置信度,结果:
- 置信度分数平均漂移 0.043–0.084;
- 在 0.8 这个常用阈值上,4%–9% 的判定直接翻转。
翻译成路由语言:你精心调好的「置信度低于 0.8 就升级到大模型」这条规则,可能只是对你当时那套提示词模板有效。换个 prompt 写法、升级个模型小版本,同样一批查询里就有百分之几会被路到不同的模型上——账单和质量随之抖动,却很难 debug。
多次采样投票,为什么不是那颗银弹?
很多人第一反应是:那我别信单次自报,改成「跑几次取多数」总稳了吧?论文给了两个不建议的理由:
- 更弱:三次采样一致性的 AUROC 只有 0.765 / 0.790,明显低于口头置信度。
- 会放大共同的错:自一致性的前提是「错误是随机的、投票能平均掉」。但实测中出现了多次采样对同一个错误答案一致投票的情况——模型对某类问题有系统性误解时,采样再多也只是更自信地错。
再叠加 3 倍的推理成本,「多采样投票」在这项测试里是又贵又不一定更准的选择。顺带一提,论文对 100 条人物传记声明的探索性审计也发现:被支持的声明和被否证的声明之间,置信度只有「适度」的差距——说明在更开放、更容易产生幻觉的生成任务上,自报置信度的区分力会进一步打折。
这对 LoopRouter 式的置信度路由意味着什么
把上面几点收敛成可落地的接入建议:
- 可以用口头置信度做第一道门控。它便宜(同一次生成里就拿到)、区分力强(AUROC ~0.95),很适合作为「要不要升级到更强模型」的初筛信号——比无脑全走大模型省钱,比多采样投票又准又便宜。
- 把「索取置信度的提示词」当成路由配置锁死。既然换个等价问法就能翻转 4%–9% 的决策,那这段提示词、置信度的输出格式、升级阈值,都应该纳入版本管理和回归测试,不能随手改。
- 别指望多采样自一致性救场。它更贵、更弱,还会在模型有系统性误解时放大错误。真要做二次确认,更值得的是换一个不同来源的判据(例如换一个模型家族交叉验证、或外挂检索核对),而不是让同一个模型多投几票。
- 关键决策别只靠自信度。它在有标准答案的事实问答上最准,在开放式生成、Agent、代码等场景会打折。高风险动作应叠加规则校验或人工兜底。
- 在你自己的数据上复测阈值。100 道 TriviaQA 得出的 AUROC 和 0.8 阈值不能照搬;不同任务、不同模型版本,曲线会移位。
一句话:置信度是一条便宜好用但会漂移的路由信号。把它当成分级路由的第一道筛子、并配上版本锁定与自己的复测,它能实打实地压成本;把它当成能一劳永逸的开关,迟早会在某次 prompt 改动后悄悄翻车。