本文基于 arXiv 论文《Where Should a Document Live: Context, Representations, or Parameters?》(arXiv:2609.17346v1)的公开摘要整理与二次分析,加入 LoopRouter 在模型接入与成本治理上的视角;原文见文末链接。文中数字沿用来源设定,建议以你自己的任务集复测。
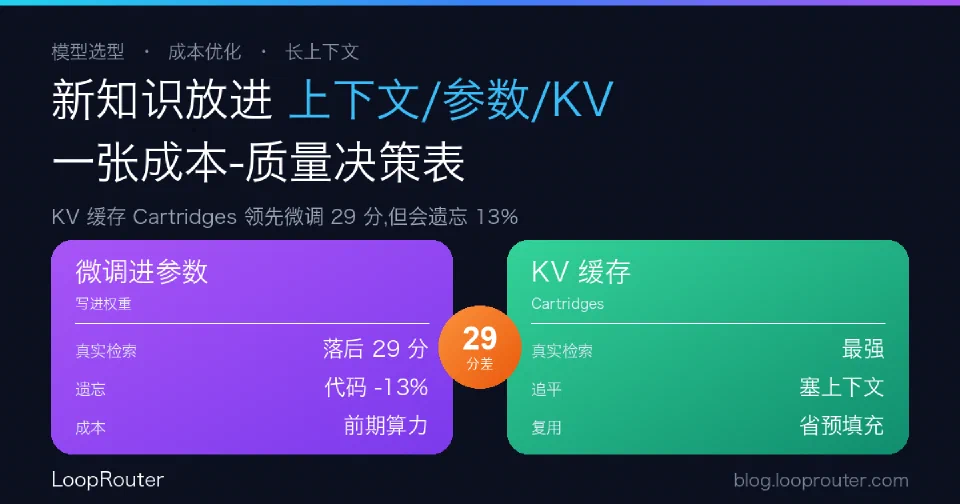
一句话结论:给大模型补充它没学过的知识,有三条路——塞进上下文窗口、微调进参数、或编码成 KV 缓存(潜在表示)。一项受控对比给出的答案是:没有单一赢家,但在真实的多文档检索场景里,KV 缓存方法 Cartridges 明显最强,领先微调约 29 分;代价是它和微调一样会灾难性遗忘,写代码任务最高掉 13%。所以「知识怎么进模型」不是技术细节,而是一道要在接入层做的成本-质量决策题。
同一批文档,为什么放的位置不同,结果差这么多?
企业接私有知识时,第一直觉往往是「塞进 prompt」或「拿去微调」。但这两者只是三选一里的两个。论文把可选路径归纳为三类,各有独立的效率、成本、性能权衡:
- 放进上下文窗口:把文档原文拼进 prompt(即 RAG / 上下文学习 ICL)。灵活、无需训练,但每次请求都按 token 计费、都要重新预填充。
- 写进参数:用全量微调或 MLP adapter 把知识「学」进权重。一次训练、长期生效,但有前期算力成本和遗忘风险。
- 编码成潜在表示(KV 缓存):把这批文档提前算成模型的 KV 缓存并存下来复用,代表方法是 Cartridges 和 Compaction。
论文在五个知识密集型基准上做了受控对比,并特意分了两种场景:一种是「理想 oracle 设定」,一种是更贴近生产的「真实多文档检索」。
谁最准?两种场景下的对比表
| 场景 | 最强方法 | 相对差距 | 关键结论 |
|---|---|---|---|
| 理想 oracle 设定 | Cartridges(KV) | 领先微调约 10 分 | 几乎所有存储预算下都最准 |
| 真实多文档检索 | Cartridges(KV) | 领先微调约 29 分、领先 Compaction 约 15 分 | 唯一能追平「直接塞上下文」(ICL)的方法 |
| 高压缩率(>50×) | —— | Compaction 反而落后微调约 10 分 | KV 压缩不是越狠越好 |
两个要点值得单独记住:
- Cartridges 是稳的赢家:无论理想还是真实场景,它都最准,真实场景下甚至能追平把全文塞进上下文的效果——但省掉了每次重复预填充的开销。
- Compaction 有甜区:只有在低压缩率时才跟得上 Cartridges;一旦压缩率超过 50 倍,质量塌得比微调还厉害。想用 KV 压缩省存储的团队,得先找到自己的压缩率甜区。
便宜准的方案,藏着一个「学了新的忘了旧的」陷阱
Cartridges 和微调虽然在各自维度占优,却共享同一个副作用:灾难性遗忘。论文点名 Cartridges、全量微调、大号 MLP adapter 都受影响,表现为:
- 通用对照基准掉约 6%;
- 写代码任务最高掉 13%。
这条边界很关键。它意味着:你为了让模型「记住」某批文档而选的高性价比方案,可能在不相关的任务上悄悄退化。如果你的模型同时还要写代码、做通用问答,注入知识前后都要跑一遍回归测试,别只盯着目标任务的分数涨没涨。
LoopRouter 视角:把「知识注入策略」当成一道路由题
这项研究对企业最实用的一点,不是「哪个方法最强」,而是**「没有单一赢家」本身**——它把知识注入从一个技术选择,变成了一道需要按请求分流的成本治理题。落到统一接入层,可以这样管:
- 高频、只读、同一批文档的问答 → 走 KV 缓存复用(Cartridges 思路),把文档预算成缓存,省掉每次请求的重复预填充,单位成本最低。
- 零散、时效性强、文档常变的查询 → 走 RAG / 长上下文,牺牲一点单价换灵活,不必为每次变动重新训练或重算缓存。
- 确实要改变模型能力或风格的场景 → 才动微调,并把「灾难性遗忘」单独列入监控项,注入前后跑通用与代码回归。
换句话说,与其在单一模型里为「知识怎么进去」纠结,不如用一层网关按请求特征把三种策略路由开来:该缓存的缓存、该检索的检索、该微调的微调。这既能拿到 Cartridges 那样的准确率红利,又能把微调的遗忘风险和长上下文的 token 账单,分别关进各自的成本笼子里。