本文基于 Simon Willison 的公开文章与多家媒体报道整理、二次分析,加入 LoopRouter 的接入/成本/路由视角;原文见文末链接。 整理时间:2026-09-09。计费数字来自第三方报道,彼此有分歧,正式接入前请以 OpenAI 官方定价页为准。
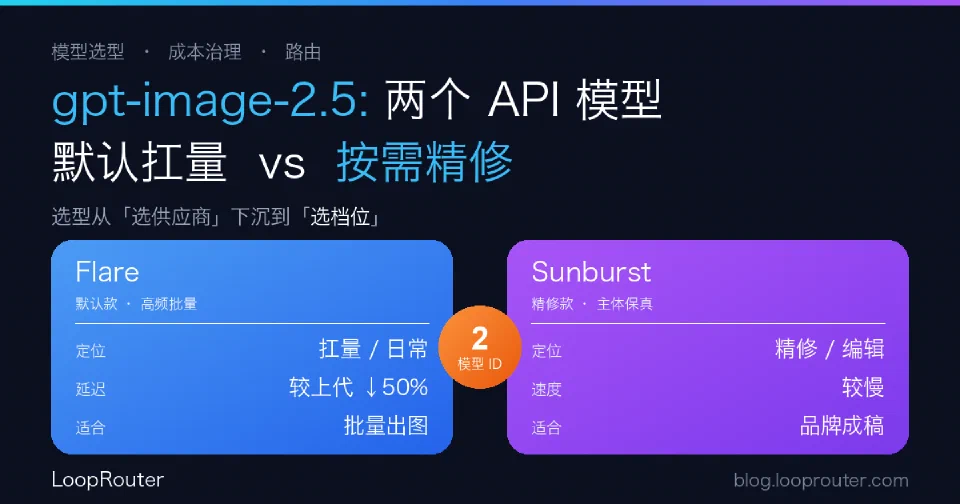
结论先行:ChatGPT Images 2.5 在 API 里给了你两个模型 ID——gpt-image-2.5-flare(默认、快、扛量)和 gpt-image-2.5-sunburst(精修、保真、较慢)。这不是"升不升级"的问题,而是一道"哪类请求走哪个档位"的路由题。
OpenAI 在 2026-09-08 发布 ChatGPT Images 2.5,官方称其系列模型已在 ChatGPT 与 API 侧累计生成"超过 30 亿张图片"。相比单纯的画质提升,对接 API 的团队真正要关心的是:多出来的这两个模型 ID 该怎么分工。
Flare 和 Sunburst 到底差在哪
两者能力同源,定位不同。官方给的选择口径很直白:编辑精度最重要就用 Sunburst,追求速度的高质量日常出图就用 Flare。
| 维度 | gpt-image-2.5-flare | gpt-image-2.5-sunburst |
|---|---|---|
| 定位 | 默认款,日常 / 高频 / 大批量 | 精修款,品牌物料 / 产品图 / 多轮编辑 |
| 速度 | 更快(官方称较 GPT Image 2 延迟降约 50%) | 较慢,生成时间更长 |
| 长处 | 高质量 + 低延迟的通用生成 | 跨多轮编辑的一致性、参考图主体保真 |
| 适合场景 | 批量缩略图、占位图、快速草稿 | 广告创意、电商主图、需要反复精修的稿件 |
2.5 这一代的共性升级是:多轮指令跟随更稳、响应更快、对参考照片里主体的保真更好——这恰恰是 Sunburst 被拉开差距的地方。
计费:先别急着算,两种说法在打架
图片类模型按 token 计费,不是按张固定价。第三方整理到的单价大致是:图片输出 $30 / 1M tokens、图片输入 $8 / 1M(缓存 $2)、文本输入 $5 / 1M(缓存 $1.25)。
但关于"比上代贵不贵",报道明显分歧:
- 一种说法:token 单价与上代 GPT Image 2 持平,等于质量和速度白升级。
- 另一种说法:逐项价格是上代的 2×,属于典型的"速度 / 质量换成本"。
作为参考,上代 GPT Image 2 按设置不同,单张大致在 $0.005–$0.21 区间浮动。这两种说法不能同时为真,所以任何迁移测算都别照抄第三方数字,务必回到 OpenAI 官方定价页核对你目标分辨率 / 质量档下的实际 token 消耗。 这也是我们反复强调的一点:计费口径永远以源站为准。
工程落地:把"选模型"变成"配路由"
同一家族出现两个 ID,最大的变化是——选型从"选哪家供应商"下沉到了"选哪个档位"。 与其在每段业务代码里写死 gpt-image-2.5-sunburst,不如在网关层按请求特征分流:
- 默认走 Flare 扛量:无参考图、单轮、批量生成的请求,直接落默认档。
- 按特征升档到 Sunburst:请求里带参考图、需要多轮精修、或标记为"品牌 / 成稿"级别时,再路由到精修档。
- 成本按档位归集:把两个 ID 的调用量和花费分开统计,才能看清"到底是精修请求在烧钱,还是批量请求在烧钱"。
这对多模型统一接入意味着什么
对用 LoopRouter 这类网关统一接入多模型的团队,gpt-image-2.5 是个很典型的例子:真正该治理的不是"要不要换模型",而是"让对的请求走对的档位"。
- 路由规则外置:把"带参考图 → Sunburst、纯文生图 → Flare"写成网关规则,而不是散落在各业务里,后续调档只改一处。
- 成本可观测:按模型 ID 拆分用量,精修档的溢价才不会被日常出图稀释掉、变成一笔算不清的总账。
- 故障兜底:当某一档位限流或不可用时,可降级到同族另一档或其他图片模型先保出图,避免整条链路卡死——这正是统一接入相对"单点写死某个模型"的价值所在。
一句话:2.5 的升级不在于画质本身,而在于它把"图片生成"正式变成了一道需要路由和成本治理的选型题。
参考来源
- Simon Willison:Introducing ChatGPT Images 2.5
- OpenAI 官方公告:https://openai.com/index/introducing-chatgpt-images-2-5/
- 第三方定价整理(口径有分歧,仅供对照):Unite.AI、DataStudios、CostGoat 等