本文基于 Simon Willison 的公开文章整理与二次分析,加入 LoopRouter 的接入/成本视角;原文见文末来源链接。所有基准数据均为 OpenAI 自报,作者本人截至发文尚未实测。
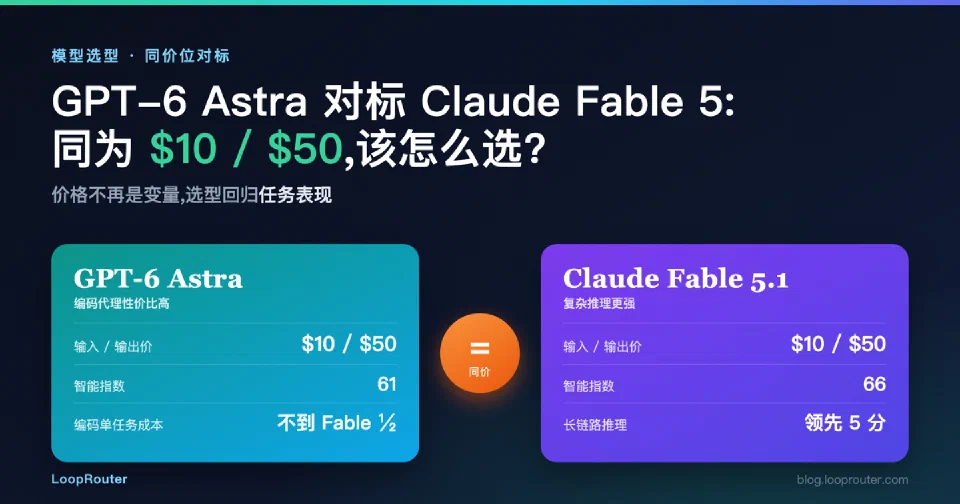
一句话结论:GPT-6 Astra 的 API 定价(输入 $10、输出 $50 / 百万 token)与 Claude Fable 5/5.1 完全一致——这是 OpenAI 第一次把旗舰模型直接钉在 Anthropic 的价格档位上。价格不再是变量,选型彻底回归"哪个模型在你的任务上更强"。
发布节奏与接入渠道
GPT-6 Astra 于 2026 年 9 月 3 日开始向少数组织灰度,数天内扩展到所有 ChatGPT Plus、Pro、Business、Enterprise 用户,并同步通过 OpenAI API 和 AWS 提供。API 模型标识为 gpt-6-astra。
对企业接入方,这意味着两条路径:直连 OpenAI API,或走 AWS 托管。多云部署的团队要注意两个渠道的灰度进度可能不同步。
价格表:三个旗舰,一个价位
| 模型 | 输入(/百万 token) | 输出(/百万 token) |
|---|---|---|
| GPT-6 Astra | $10 | $50 |
| Claude Fable 5 | $10 | $50 |
| Claude Fable 5.1 | $10 | $50 |
这个"完全对齐"不是巧合。Simon Willison 直言 Astra “明显是 OpenAI 的 Fable 竞品”。当两家的旗舰定价一模一样,过去"贵的那个是不是值得"的讨论就消失了,剩下的只有任务级别的能力对比。
基准分数:Astra 没有全赢
按 OpenAI 自报数据和第三方指数,Astra 的表现是"局部领先、总分落后":
| 维度 | GPT-6 Astra | 对照 |
|---|---|---|
| Artificial Analysis 智能指数 | 61 分 | 比 Claude Fable 5.1(max)低 5 分,与 GPT-5.6 Sol 持平,也落后 Meta Muse Spark 1.3(max) |
| 编码代理指数 | 单任务成本不到 Fable 5 的一半,得分相同 | 成本效率显著占优 |
| ExploitBench(安全) | 100% | GPT-5.6 Sol 为 78.5% |
| SRE-Bench 二进制逆向 | 99.2%(四次尝试内) | GPT-5.6 Sol 为 68.7% |
| 长上下文八针检索 | 256K–512K 区间 100%;512K–1M 区间 96.3% | 长上下文是明确亮点 |
为什么 ARC-AGI-3 的 99.9% 要打个问号
Astra 在 ARC-AGI-3 上的成绩是这次发布里最戏剧性的数字,但拆开看有重要限定:
- 用 OpenAI 自定义的 Provider Adapter harness:99.9%,花费约 1.9 万美元;
- 用 ARC-AGI 默认测试框架:只有 62.7%,花费约 2.6 万美元。
同一个模型,换个运行框架,分数差了 37 个百分点。ARC-AGI 官方说明这个定制框架"在请求间保留不透明的推理状态,并对长对话做压缩"。换句话说,分数不只属于模型,还属于围绕模型搭的那套脚手架。企业做选型评测时,同样要警惕:你在自己的 harness 里测出来的结果,才是你会得到的结果。
LoopRouter 视角:同价位时代,路由策略怎么变
当两家旗舰价格完全相同,多模型接入的逻辑从"按预算分层"变成"按任务分流":
- 编码代理类流量可以优先灰度 Astra——自报数据显示它用不到一半的单任务成本拿到与 Fable 5 相同的编码代理分数(成本差异来自完成任务消耗的 token 量,而非单价)。
- 复杂推理、长链路任务继续留在 Fable 5.1,智能指数仍领先 5 分。
- 两家同价让"双活互备"第一次没有成本惩罚:通过统一网关同时接入 OpenAI 与 Anthropic,任何一家故障时切到另一家,预算不变。
对用 LoopRouter 这类统一接入层的团队,建议先用真实流量的 5–10% 对 gpt-6-astra 做影子评测,拿到自己任务上的通过率和实际 token 消耗,再决定分流比例——别直接采信任何一方的自报基准。
常见问题
见页面 FAQ 区。核心提醒:所有基准数据为 OpenAI 自报,Simon Willison 本人尚未实测;ARC-AGI-3 高分依赖定制测试框架,横向对比时需注明运行环境。