本文基于 OpenAI 官方博客(Cognition 使用 GPT-6 Astra 帮助 Devin 测试自身产出)与公开报道、第三方分析整理并二次组织,加入 LoopRouter 在多模型接入、任务级路由与成本治理上的视角;原文见文末链接。文中基准分数与成本比例沿用 Cognition 公布的口径,均为其内部基准结果,建议以你自己的评测复核。
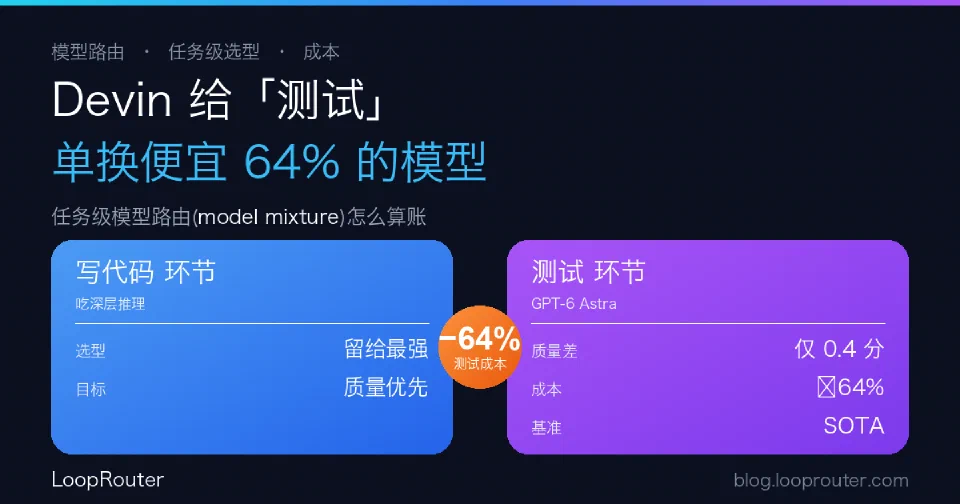
一句话结论:Cognition 没有把 Devin 全程升级到最强模型,而是给「测试与验证」这一个环节单独换上了 GPT-6 Astra——在它自家的 FrontierCode 1.1 基准上只落后 Fable 5 约 0.4 分,成本却低 64%。这不是一次简单的换模型,而是一个信号:模型选型的最小单位正在从「一个应用配一个模型」下沉到「一个任务配一个模型」。而这套账要算对,关键不在省了多少,而在你敢不敢信 Agent 自己给出的那个绿色对勾。
真正的新闻不是又出了个新模型,是「谁干哪段活」变了
表面看,这是「Devin 接入了 OpenAI 的 GPT-6 Astra」。但值得记下的那句话藏在用法里:Astra 被指派去做的不是写代码,而是证明代码能跑——在人看代码之前,先跑测试、录屏、出报告。
Astra 在 Devin 里具体承担这几件事:
- 跑测试:执行用例,产出「通过 / 未覆盖」的清单;
- 录过程:比如把一个 iPhone 小游戏在模拟器里跑起来录下来,作为「它确实能用」的视频证据;
- 出报告:说明测了哪些、还剩哪些没测,让工程师快速定位要盯的地方;
- 看图修 bug:客户发来一张报错截图,Devin 用 Astra 定位并修复,再回一张修好后的截图。
Cognition 研究 SVP Silas Alberti 的说法很直白:Astra 强在「计算机操作 + 写作 + 对代码库的理解」,所以录出来的视频更好懂、报告更清楚——测试质量是「开箱即用」地涨的,不是靠额外调教。
为什么值得为「测试」单独选一个模型:0.4 分 vs 64%
关键在于测试和写代码是两类不同的活,对模型的能力画像要求不一样。Cognition 用自家基准量化了这个取舍:
| 维度 | GPT-6 Astra 的表现(Cognition 口径) |
|---|---|
| FrontierCode 1.1(真实工程任务,评质量与可合并性) | 超过 Fable 5.1;仅落后 Fable 5 约 0.4 分 |
| 相对成本 | 比 Fable 5 低 64% |
| 内部测试基准 | 新 SOTA,测试更全面、报告更清楚、视频证据更好懂 |
| API 定价 | 输入 $10 / 输出 $50 每百万 token,与 Claude Fable 5/5.1 一致 |
把这张表翻译成路由决策:在「测试」这个高频、且结果可被客观核验的环节,0.4 分的质量差几乎感知不到,64% 的成本差却是真金白银。于是最优解不是「全程用最贵的」,而是把最贵的模型留给写代码这种吃深层推理的环节,把测试切给性价比更高的 Astra。
顺带一提,Astra 与 Fable 5 的 API 单价其实相同(都是 $10/$50),所以这里的「便宜 64%」不是单价便宜,而是在同类任务上用更少的 token / 更少的来回达到同等效果——这也提醒:比模型别只比标价,要比「完成单位任务的总成本」。同价位怎么选,我们在另一篇 Astra 与 Fable 5 的对标里展开过。
这就是「model mixture」:路由粒度从应用下沉到任务
Devin Cloud 的官方描述里,Astra 是「模型混合(model mixture)」的一员,而不是全局替换。这个词点出了趋势:
- 传统模型路由:多在入口按「请求难度」挑一个模型,一次请求走一个模型;
- model mixture:在一个 Agent 的工作流内部,按环节分配不同模型——规划、写代码、跑测试、看截图修 bug,可以各用各的最优解。
换句话说,选型的最小单位正在从「这个应用用哪个模型」变成「这个任务节点用哪个模型」。一个自主 Agent 的一次完整作业,背后可能是三四个模型接力,每个都为它那段活挑过。
LoopRouter 视角:任务级路由的价值,和它的隐藏成本
Devin 的做法印证了 LoopRouter 一直强调的思路——统一接入多模型,然后按任务而非按应用去路由。但要把这套东西落到自己的系统里,有三件事得先想清楚:
- 省钱的杠杆在「高频且可核验」的环节。测试、分类、摘要、格式化这类结果能被客观判对错、又跑得频繁的任务,是切换到高性价比模型收益最大的地方;深层推理、架构决策这类低频高危环节,别为省钱降配。
- 多模型接力意味着多一层接入与故障面。工作流里每多一个模型,就多一个供应商依赖、多一个限流/故障点。统一网关 + 故障切换在这里不是锦上添花,而是让「模型混合」能稳定跑起来的前提——某个模型挂了,测试环节要能自动降级到备选,而不是整条流水线停摆。
- 把「路由决策」本身的成本也算进去。无论是让另一个模型判断该走哪条路,还是维护一套评测来校准路由规则,这层开销都要计入总账,别只盯着被选中模型的单价。
别把「少看代码」读成「信绿对勾」:一个必须先测的数字
这次announcement里最诱人的一句是「让工程师少看代码、多发布」。但要注意:官方原话是「以……为目标(with the goal of)」,这是一句路线图,不是一个已被测出来的结果。第三方分析点出了两个真实风险:
- 验证者和写代码的是同一个大脑:模型如果臆想了一个不存在的 API,它很可能同时写出一个断言该 API 成立的测试,于是错误被双重盖章通过;
- 覆盖率剧场:行覆盖率高,只证明「跑过的代码行多」,不证明「测到了要紧的分支」。
所以在把任何「Agent 自测」塞进合并流程前,先做一个实验、测一个数字:把历史上真实出过 bug 的「修复前代码」喂给它,看它生成的测试能不能抓出那些已知 bug。这个假阴性率,才是决定你敢不敢信那个绿对勾的唯一硬指标。涉及钱、安全、数据删除的改动,无论数字多漂亮,都保留人工复核。
落地一句话:任务级模型路由(model mixture)是真实且正在发生的降本手段——把对的模型放到对的环节,能在几乎不掉质量的前提下砍掉一大截成本。但它的前提是两件事:一个能统一接入、自动故障切换的路由层,和一套能量化「验证到底靠不靠谱」的评测。前者决定它跑不跑得稳,后者决定你敢不敢真的少看代码。