本文基于 arXiv 论文《Accelerating Dense LLMs via L0-regularized Mixture-of-Experts》(arXiv:2609.21672v1,原发表于 ACL 2025)公开内容的整理与二次分析,加入 LoopRouter 在成本治理与接入路由上的视角;这是一篇技术方法论文,本文作为「降本技术选型」的科普与延伸,数据引自原文、未经独立复现。原文见文末链接。
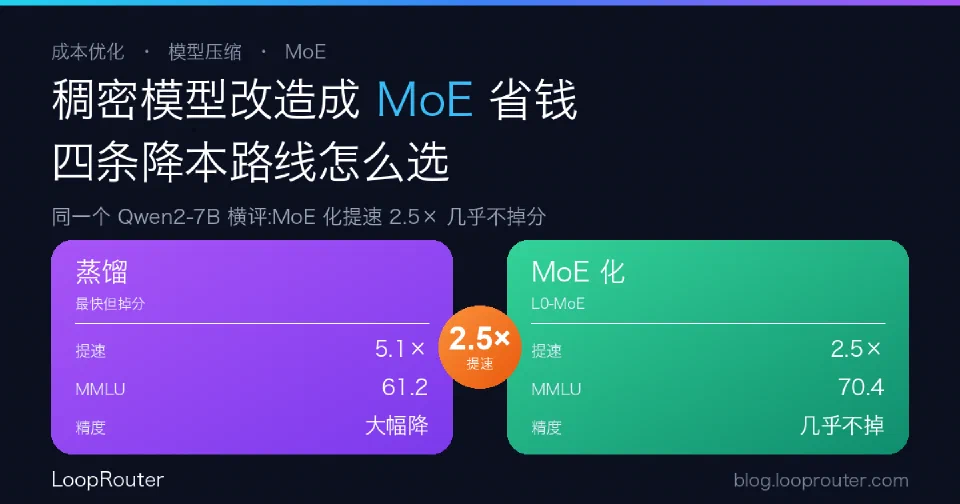
一句话结论:自托管模型想压推理成本,常见四条路——量化、剪枝、蒸馏,以及把稠密模型改造成 MoE。这篇论文用同一个 Qwen2-7B把四条路放在一起比,给出一个清晰信号:MoE 化能在几乎不掉分的前提下提速 2–2.5 倍,蒸馏最快(5.1 倍)但精度损失也最大。但更重要的判断是:「模型内压缩」和「接入层路由」是两条正交、互补的降本路线——压缩决定「每个模型档位多便宜」,路由决定「每个请求走哪一档」。
L0-MoE 一句话原理:让每次推理少过参数
推理为什么贵?本质是每生成一个 token,都要把请求过一遍模型的大部分参数。稠密模型没得挑,全量参与。
L0-MoE 的思路是把一个已经训好的稠密模型改造成稀疏 MoE:
- 用 L0 正则给前馈层(FFN)的中间维度学一个可训练的二值掩码,把不重要的维度关掉,从一个稠密 checkpoint 里裁出多个「领域专家」。
- 推理时不再全量激活,而是每个 token 只走 64 个专家里的 top-2(底部若干层保持稠密)。
- 结果:参数总量还是 23–25B,但每次实际激活的只有约 2.8–3.2B——于是变快、变省。
配套还有一个 Cluster Confusion Matrix(CCM):先把语料编码成语义向量、用 K-means 聚出领域簇,再按「领域语义距离」重排训练顺序,让路由器学会把 token 分给对的专家。
关键数字:提速 2–2.5 倍,精度基本不动
在三个稠密底座上改造的效果(综合 MMLU / GSM8K / HumanEval / BBH 的平均分):
| 底座模型 | 提速 | 改造前均分 | 改造后均分 |
|---|---|---|---|
| Llama-3-8B | 2.0x | 53.5 | 53.3 |
| Mistral-7B | 2.1x | 50.4 | 51.4 |
| Qwen2-7B | 2.5x | 66.0 | 66.1 |
Mistral 那一行甚至略有提升。也就是说,这套改造的卖点是「几乎白赚的 2 倍速度」,而不是拿精度换速度。训练成本也不算离谱:用了约 30B token(RedPajama)。
四条降本路线横评:同一个 Qwen2-7B 上比
这才是对选型最有用的部分。论文把四类主流压缩手段放在同一个 Qwen2-7B上比(MMLU / GSM8K / 提速):
| 压缩手段 | MMLU | GSM8K | 提速 |
|---|---|---|---|
| MoE 化(L0-MoE) | 70.4 | 80.5 | 2.5x |
| 剪枝(LLM Shearing) | 68.2 | 75.5 | 2.6x |
| 量化(GPTQ) | 67.8 | 73.8 | 1.8x |
| 蒸馏(RKD + CoT) | 61.2 | 60.2 | 5.1x |
怎么读这张表:
- 要「速度 × 精度」平衡:MoE 化最优——提速 2.5 倍且精度几乎不掉。
- 要极致速度、能接受掉分:蒸馏——5.1 倍最快,但 MMLU/GSM8K 大幅下滑,适合对质量不敏感的高频简单任务。
- 要最省改造成本:量化——不用重训,但加速有限(1.8 倍)。
- 剪枝在速度上和 MoE 化接近,但精度略逊。
没有免费午餐,选哪条取决于你的目标函数。
别忽略的适用边界
论文自己列了几条限制,选型前值得记住:
- 规模有限:只在 7–8B 量级、30B token 上验证,没和 DeepSeek-MoE、Mixtral 这类用万亿 token 训的大 MoE 正面比。
- exposure bias:专家按「序列级」聚类切,但 MoE 路由是「token 级」的,两者错配。
- K 不通用:最优专家数依赖语料多样性,换语料未必迁移。
- 大模型未测:没在 70B 以上验证(作者猜更大模型收益可能更高)。
一句话:它是一个有说服力的中小模型自托管降本方案,但别当成放之四海的银弹。
这对 LoopRouter 式的多模型接入意味着什么
关键是想清楚:降本有两条正交的路线,别只走一条。
- 路线一,模型内压缩(量化 / 剪枝 / 蒸馏 / MoE 化):由谁部署谁做,决定「单个模型档位有多便宜」。这篇论文帮你在这条路里选手段。
- 路线二,接入层路由:由平台层做,决定「每个请求走哪个模型 / 哪个档位 / 哪个供应商」。
两者互补,合起来才完整。落到实践:
- 把压缩后的自托管模型当作「便宜档」,把云上的强模型当作「高质量档」。
- 在接入层按请求难度 / 任务类型分档路由:简单请求走便宜档,难请求(或便宜档置信度低)再升级到强模型。
- 叠加语义缓存减少重复调用,叠加故障切换在某档不可用时兜底。
- 对走 API 的多数团队:这类「模型内成本差异」最终会表现为同名模型不同供应商的价格 / 速度不同——在接入层做等价选型和分档路由,同样能吃到降本红利,而不必自己训练。
模型内压缩决定每一档多便宜,接入层路由决定每个请求走哪一档——两条路线一起用,才是可持续的推理成本治理。
参考来源
- Accelerating Dense LLMs via L0-regularized Mixture-of-Experts,arXiv:2609.21672v1(ACL 2025)— https://arxiv.org/abs/2609.21672v1