本文基于 Hacker News 对 DeepSeek v4.1 Flash 发布的讨论(item 49624603)及其中引用的官方公告整理与二次分析,加入 LoopRouter 在模型选型与统一接入上的视角;原文见文末链接。部分数字来自用户评论、未经官方证实,已在文中标注。
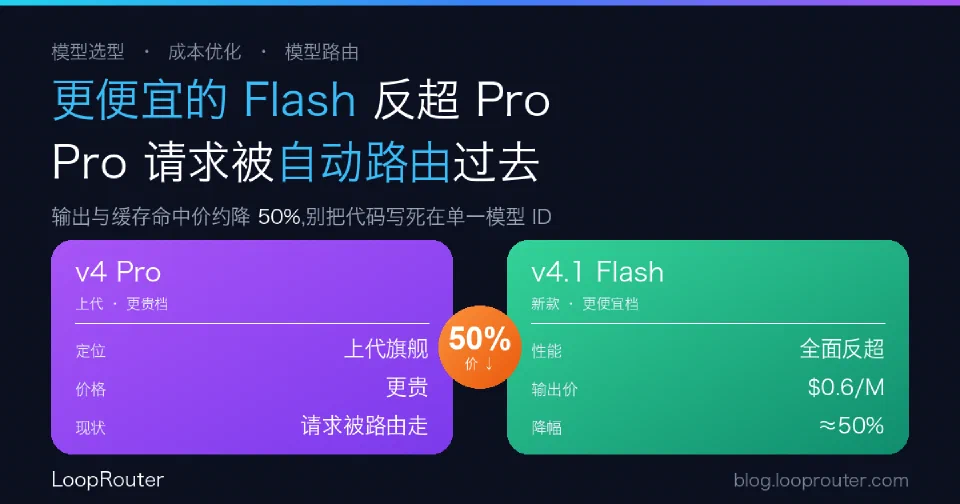
一句话结论:DeepSeek 发了 v4.1 Flash,官方称它在性能、成本、速度上全面超过 v4 Pro,输出与缓存命中价约降 50%。更值得接入方注意的是那个不起眼的细节——在 v4.1 Pro 上线前,所有 Pro 请求会被自动路由到 Flash、按 Flash 价计费。这意味着你调的接口没变,背后的模型和单价却被平台换了。模型迭代进入「按月降价 + 悄悄换模型」的节奏后,把代码写死在单一模型 ID 上,已经是一种风险。
发生了什么:更便宜的 Flash 反超了更贵的 Pro
按官方公告(北京时间 2026-09-10 前后发布),核心信息有三条:
- 能力:v4.1 Flash 声称在性能、成本、速度、任务完成时间等所有关键指标上,已全面超过 v4 Pro。
- 定价:自 2026-09-10 12:00(北京时间)生效的非高峰单价如下表。
- 过渡路由:v4.1 Pro 发布前,所有 Pro 请求路由到 v4.1 Flash,按 Flash 价计费。
| 项目(每百万 Token) | 非高峰价 | 说明 |
|---|---|---|
| 输入 · 缓存命中 | $0.003 | 较旧价约降 50%(旧价约 $0.007) |
| 输入 · 缓存未命中 | $0.15 | 较旧价约降 32%(旧价约 $0.22) |
| 输出 | $0.6 | 较旧价约降 50% |
高峰时段价格为非高峰的 2 倍。旧价对比来自 HN 用户评论(riknos314 等),非官方口径,仅供量级参考。
值得留意的是行业信号:一个「更便宜」的档位(Flash)在关键指标上反超了「更贵」的档位(Pro)。这打破了「贵=强」的默认假设——选型时按名字里的 Pro/Flash 去猜强弱,越来越不靠谱,得看具体任务上的实测。
速度与上下文:官方给的少,评论给的多(但要打折看)
这两项官方公告说得很含糊,大部分数字来自社区,引用时要标注不确定性:
- 速度:Beta 测试者报告 >400 TPS;有用户实测 preview 版约 300–400 tok/s。均为用户口径。
- 上下文窗口:官方公告未明确给出。仅有本地运行相关讨论提到 v4 Flash 可在 128G 设备上跑 256k context——这是本地部署场景,不等于 API 端的窗口。
结论:速度看起来不错,但正式 SLA 数字要等官方文档;上下文窗口不要拿评论当准。
藏在公告里的主角:一次「官方模型路由」
真正对接入方有信息量的,是那句「v4.1 Pro 发布前,Pro 请求路由到 Flash 按 Flash 价计费」。把它翻译成接入语言:
- 同一个模型 ID / 端点,背后的实际模型被平台替换了;
- 计费口径也随之改变(按 Flash 价)。
这就是模型路由在生产里最真实的一面——路由权在平台手里,你调的名字稳定,行为却可能漂移。它带来两个具体风险:
- 行为漂移:同样的 prompt 落到不同模型,输出质量、格式、风格都可能变。端点没变 ≠ 结果没变,关键任务需要回归测试来兜住。
- 数据合规:有评论提醒「DeepSeek API 会用你的数据训练」。切换或提前测试新模型时,先确认数据政策是否符合你的合规要求。
对企业选型与接入意味着什么
模型正在进入「按月降价 + 平台随时换模型」的节奏——这个月 Flash 反超 Pro,下个月可能又冒出更便宜的一档。从 LoopRouter 的模型选型与统一接入视角,应对方式不是追着每次发布改代码,而是把「换模型」这件事变便宜:
- 别把业务写死在单一模型 ID 上。在业务代码和具体模型之间放一个统一接入层,让模型选择变成配置,而不是硬编码。
- 让比价、灰度、回退发生在路由层。新模型更便宜时,先灰度一小部分流量验证质量,达标再放大;官方强制路由或涨价时,能快速改道到备选模型甚至备选供应商。
- 用你自己的任务集验收,而不是名字或榜单。Flash 反超 Pro 说明「贵=强」不成立;上线前用真实业务样本测质量、成本、延迟三件套,别凭型号名下判断。
- 把数据合规纳入切换清单。每次接入新模型/新供应商,合规审查和技术验证同等重要,尤其涉及会用数据训练的 API。
一句话:当模型方开始替你做路由决策,你更需要一层自己能控的路由——让「省下来的成本」真正落袋,而不是被行为漂移或锁定风险吃回去。
来源:Hacker News《DeepSeek launching v4.1 flash cheaper and more capable than v4 pro》(397 points,204 comments)——https://news.ycombinator.com/item?id=49624603