本文基于 InfoQ 中文(2026-09-10,作者褚杏娟)对 DeepSeek 技术报告的报道整理与二次分析,加入 LoopRouter 的模型选型与成本视角;数据均转述自该报道,笔者未独立复现原始报告。原文见文末链接。
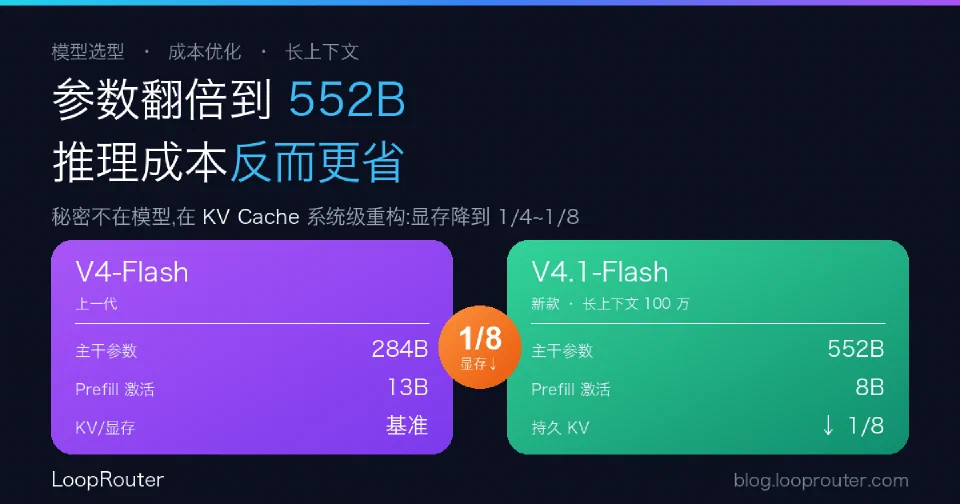
一句话结论:DeepSeek V4.1-Flash 主干参数从 284B 几乎翻倍到 552B,推理成本却不升反降——秘密不在模型本身,而在对 KV Cache 的系统级重构。这件事对做模型选型的人是一个明确信号:长上下文场景下,“每 Token 单价"已经不能代表真实成本,显存占用和长序列的边际计算才是。
参数翻倍,算得反而更少
先看反直觉的地方:
| 指标 | V4-Flash(上一代) | V4.1-Flash(新) |
|---|---|---|
| 主干参数 | 284B | 552B(另有 196B Engram 记忆参数) |
| Prefill 每 Token 激活 | 13B | 8B |
| Decode 每 Token 激活 | — | 16B |
| 上下文上限 | — | 100 万 Token(原生多模态 MoE) |
关键在于:参数总量涨了,但读 Prompt(Prefill)时真正参与计算的激活参数反而更少(8B vs 13B),报告称 Prefill 计算量"接近减半”。参数是"备着的容量",不是每次都全用上——这正是 MoE + 架构重构的价值。
KV Cache 重构:省的是显存,不是参数
长上下文推理真正的成本黑洞是 KV Cache 的显存占用。V4.1-Flash 的几项系统级改动:
- CED 架构:40 层语言主干拆为 20 层因果编码器 + 20 层 Decoder;前 2 层用 SWA,其余用 CSA2。
- CSA2 跨层共享 KV:提供 Full / Reindex / Reuse 三种模式,让 KV Cache 在 Transformer 层之间复用。
- 分层稀疏索引器:最多选 2048 个 Block(每 Block 8 个位置),在最多 16384 个候选位置里找 Top-512,把长上下文注意力压到近似常数级。
- FP4 量化:把 FP4 扩展到 Main KV Cache;对量化敏感的 SWA KV 仍保留 FP8。
- SWA KV 策略:不再长期写 SSD,改放约 10% Host DRAM 的短期分布式内存池,TTL 分钟级,用 SWA Bounded Replay 近似恢复。
数据:百万 Token 下显存降到 1/4~1/8
这些改动落到硬指标上:
| 指标 | 结果 |
|---|---|
| Global KV Cache | 约 890 Byte/Token,约为 V4-Flash 的 1/4(百万 Token 约 890MB) |
| Persistent KV Cache | 最终降到 V4 约 1/8 |
| Decode FLOPs(4K→1M,增长 256×) | 单 Token 仅增加约 25% |
| mHC(多头压缩) | 改单 Pass,Activation Memory Traffic 相比原始实现减半 |
此外,DSpark(取代 MTP)用 3 个 Transformer Block、一次 Forward 并行预测 5 个 Draft 位置;多模态侧用 3×3 Pixel-Unshuffle 把视觉 Token 减到 1/9,支持约 1344×1344 分辨率。
适用边界
报告聚焦"长上下文 Agent 部署成本优化",目标读者是 AI 基础设施工程师、大模型系统架构师、Agent 应用开发者。后训练沿用 SFT/RL/OPD,无新 RL 方法。以上数据均来自 InfoQ 对 DeepSeek 技术报告的转述,笔者未独立复现,引用时请以官方技术报告为准。
从 LoopRouter 视角:选型别只盯着单价
这次架构升级对做多模型接入和选型的人,有一个很实际的提醒:
- 单价 ≠ 真实成本。 长上下文 Agent 的成本大头在 KV Cache 显存和长序列 Decode 的边际计算,这些被架构差异拉开的差距,不会写在报价单的"每 Token 多少钱"里。
- 选型要看成本曲线,而非成本点。 同样标称支持长上下文,不同模型在 100 万 Token 下的显存占用和 Decode 边际成本可能差好几倍。评估时应该把"上下文长度 vs 成本"的曲线纳进来。
- 路由决策可以更精细。 当一个模型在长上下文场景把边际成本压得很低,就值得在路由层为"长文档/长会话"这类请求单独指定它,而把短请求路由到更便宜的小模型——这正是模型路由做成本治理的空间。
关于 V4.1-Flash 的定价与"官方路由"策略,可参见我们此前的拆解:DeepSeek v4.1 Flash 全面超过 v4 Pro。本文补的是它"为什么便宜"的架构那一半。
来源
- InfoQ 中文《参数几乎翻倍,推理反而更省:DeepSeek V4.1-Flash 重构 KV Cache》(2026-09-10):https://www.infoq.cn/article/sbaJrAa8VTIRKIPCpKlo