本文基于 InfoQ 中文(作者蔡芳芳,2026-09-09)对招商银行 AI 加速卡统一管理实践的公开报道整理与二次分析,加入 LoopRouter 在成本治理与模型路由上的视角;原文见文末链接。文中数字与架构沿用来源设定,具体数值以官方案例为准。
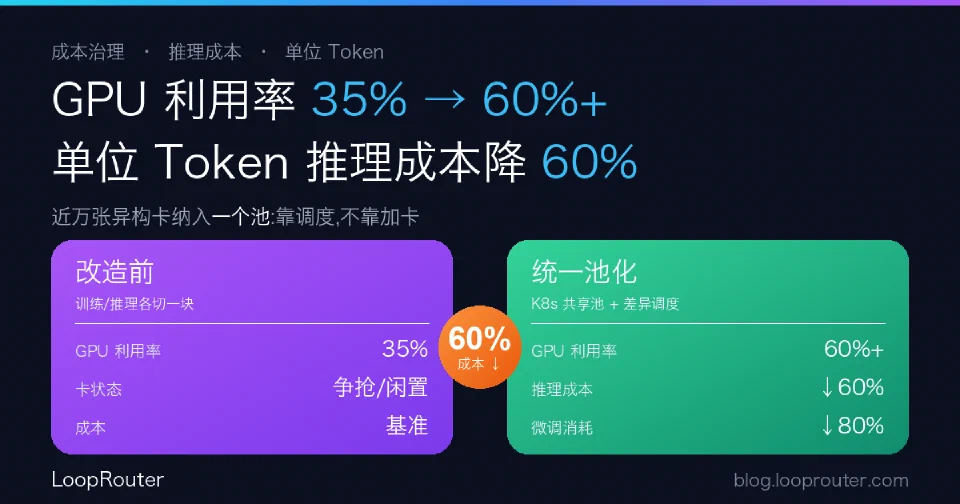
一句话结论:招商银行把近万张异构加速卡塞进一个 Kubernetes 统一资源池,GPU 利用率从 35% 提到 60%+,相同条件下每百万 Token 推理成本降了 超 60%。它没有靠买更多卡,而是靠「共享一个池、但给训练和推理不同的调度规则」把闲置榨干。这套打法的门槛是万卡级自建集群——但它真正值得所有人抄的,是那个第一指标:把成本盯在「单位 Token」上,而不是「买了多少卡」上。
数字先摆出来:一次调度改造省了多少
这个案例拿下了 CNCF 最终用户案例研究大赛冠军(2026 年 9 月,上海 KubeCon 周边),核心成果可以量化成几个数:
| 指标 | 改造前 | 改造后 |
|---|---|---|
| GPU 利用率 | 35% | 60%+ |
| 每百万 Token 推理成本 | 基准 | 下降超 60% |
| 纳管加速卡 | 分散 | 99% 资源、近 10000 张异构卡统一 |
| 多租户微调资源消耗 | 基准 | 降低 80%、训练密度 ×5 |
注意「相同模型和服务条件下」这个前提——它不是换了更便宜的模型来降本,而是同样的模型、同样的服务质量,纯靠把底层资源用满,把每百万 Token 的分摊成本压下来。这正是「成本治理」和「模型降级」的分水岭:前者不牺牲效果。
卡为什么会闲:三类负载在抢同一批加速卡
利用率只有 35%,不是卡不够,是卡在互相打架。文章点出三种负载的冲突:
- 分布式训练要的是稳定、连续、可预测的资源。麻烦在于:部分 Worker 还没就绪时,已经分配出去的卡就在那儿空转等人。
- 在线推理负载波动大,峰谷差明显,依赖的是快速弹性扩缩容,而不是长期占着一堆卡。
- **多租户微调(LoRA)**大量占用基础模型副本和加速卡——每个租户一份基础模型,副本越多越浪费。
三者峰谷错开,如果按老办法给每类负载物理切一块固定资源,结果就是谁都吃不满,平均下来利用率自然低。
解法:共享一个池,但给训练和推理不同的调度机制
核心策略一句话概括:底层资源池共享,上层为训练和推理保留不同的运行与调度规则。落到组件上是四件套(都跑在 Kubernetes 统一控制平面上):
| 组件 | 解决的问题 |
|---|---|
| Kueue | 训练任务的准入、队列与配额管理——资源没全就绪不提前启动,消灭「占着卡等人」的空转 |
| KEDA + Prometheus | 在线推理按实时业务信号弹性扩缩容,峰谷跟着负载走 |
| HAMi | 训练/推理间更细粒度地切分异构卡,解决单卡吃不满 |
| Fluid | 加速训练数据集、模型权重、Checkpoint 的访问,减少「等数据」的空等 |
多租户微调那块单独用了自研的 Twinkle 框架:默认允许 5 个 LoRA 租户共享同一个基础模型实例,把基础模型副本从 5 份直接减到 1 份——这就是微调侧资源消耗降 80% 的来源。
后续规划里还有两个方向值得记:一是扩展 KEDA 让部分推理服务接近 Serverless、无请求时缩容到零;二是建立面向「单位成本」的容量管理机制。方向很明确——把成本颗粒度做到单位 Token。
这套打法的门槛,和它真正可迁移的部分
要泼盆冷水:上面这套是万卡级自建集群的玩法。Kueue/KEDA/HAMi/Fluid 全套搭起来、还要自研微调框架,对应的是金融机构级的基础设施团队和 SRE/MLOps 投入。绝大多数团队既没有近万张卡,也没有养一支云原生平台团队的预算。
但别急着划走——这个案例真正普适的,是它的第一指标选择:不盯「买了多少卡」,盯「每百万 Token 花多少钱」。这个视角对纯 API 调用方同样成立。
对没有 GPU 的团队:同样的账,在应用层怎么算
招行是在「资源层」把利用率提上去,从而摊薄单位成本。如果你不持有 GPU、只调 API,同一笔账可以搬到应用层来做——目标一致:让每一分钱买到更多有效产出。从 LoopRouter 的成本治理视角,有三条可直接落地:
- 把「单位 Token 成本」设成北极星指标。别只看总账单,看的是「完成同一个任务花了多少钱」。招行降的是分摊成本,你要降的是每类请求的实际单价。
- 用模型路由替代「资源切分」。招行让训练和推理共享池、按负载调度;你可以让不同难度的请求共享一个统一接入端点、按难度路由——高频低难度走便宜模型,低频高价值走强模型。把简单请求从贵模型上挪走,等价于把「贵资源的利用率」提上去。
- 让降本不牺牲效果。招行强调「相同模型和服务条件下」降本,这条红线值得抄:成本治理不是无脑降级,而是让每个请求匹配到「刚好够用」的模型和价位,统一接入层负责在背后比价、切换、兜底。
一句话:万卡集群靠调度把利用率榨满,API 调用方靠路由把每个请求放到对的模型上——两者是同一道成本治理题的两种解法。你不一定买得起前者,但后者今天就能开始算这笔账。
来源:InfoQ 中文《招商银行统一近万张 AI 加速卡实践》(作者蔡芳芳,2026-09-09)——https://www.infoq.cn/article/UN2Gt8aKT40ed5z52WuL