本文基于 arXiv 预印本《Clean Scores, Buried Evidence, and Confident Wrong: A Receipt-Based Audit of Frontier Agentic QA》(arXiv:2609.15319v1)的公开内容整理与二次分析,加入 LoopRouter 在模型选型、成本治理与路由/故障切换上的视角;原文见文末链接。该研究为合成「数据室」上的预印本、且明确声明不做模型排名,文中数字请读作「方法示例」而非厂商座次,建议以你自己的数据复测。
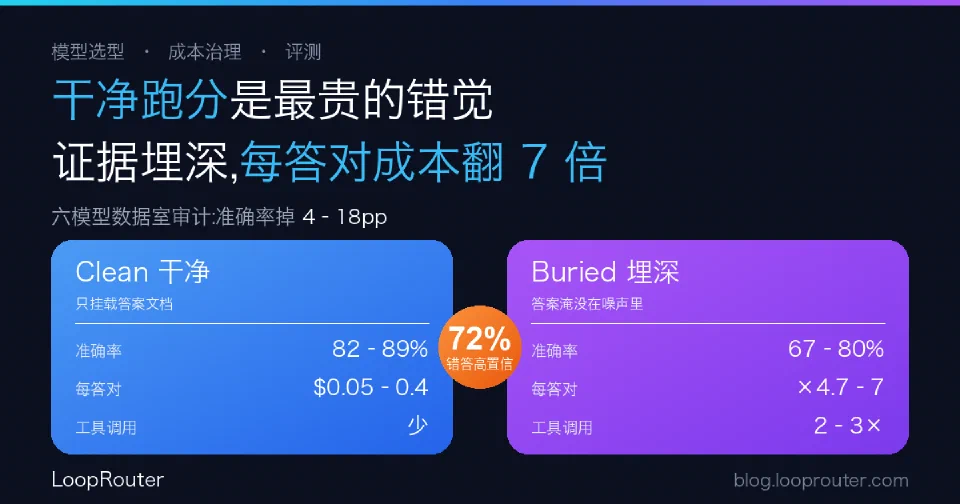
一句话结论:把同一批题目的答案证据从「干净文档」挪进「带噪声的真实文件堆」后,六家前沿模型的准确率掉了 4–18 个百分点,而每答对一题的成本涨了 4.7–7 倍、工具调用次数翻了 2–3 倍。更要命的是,模型在变难时行为分成两派:有的开始老实说「我不确定」,有的照样以 90%+ 的置信度自信答错。这三件事合起来给出一个选型铁律——别用干净跑分选模型,要按「真实条件下每答对一题的总成本 + 它错的时候会不会承认」来选和路由。
真正的新闻:同一个模型,换个「找证据的难度」就判若两人
多数榜单的隐含假设是:把答案所在的文档直接喂给模型。这项审计换了个更接近生产的问法——它搭了一个合成的「数据室」(room02,一个只读的金融/保险文件夹),41 道题,声明跳数 2–5 跳,每题跑 3 个随机种子,并给模型配齐 bash / python / read_file / grep / find 工具。然后设两种条件:
- clean(干净):只挂载含答案的文档;
- buried(埋深):挂载整个文件夹,答案淹没在噪声里。
差别不是「换了一批难题」,而是同一批题、只改变找证据的难度。结果如下。
准确率:普遍下滑,但每家掉得不一样
| 研究中的模型(合成命名) | clean 准确率 | buried 准确率 | 落差 |
|---|---|---|---|
| OpenAI · GPT-5.6-sol | 82.9% | 78.9% | −4.1 pp |
| Anthropic · Fable 5 | 89.4% | 77.9% | −11.6 pp |
| Zhipu · GLM-5.3 | 89.4% | 80.5% | −8.9 pp |
| Alibaba · Qwen3.8-Max | 87.0% | 74.0% | −13.0 pp |
| Google · Gemini-3.1-Pro | 85.2% | 67.5% | −17.8 pp |
| Meta · Muse-Spark 1.2 | 82.9% | 74.0% | −8.9 pp |
读法:clean 分数几乎看不出谁强谁弱(都在 82–89% 挤成一团),但一进 buried,差距立刻拉开到 10 个百分点以上。如果你只看第一列选型,几乎是在掷骰子。在最深的 5 跳题上,埋深后正确率从 38% 到 71% 不等——真正吃力的活,才是模型分化的地方。
成本:单位正确答案的账单被放大 4.7–7 倍
准确率下滑只是一半故事。另一半在账单上——模型在难题里反复调工具、来回试错,token 越烧越多,答对率却在降,于是「每答对一题的成本」被两头放大:
| 模型 | clean 每答对成本 | buried 每答对成本 | 放大倍数 |
|---|---|---|---|
| OpenAI | $0.055 | $0.372 | 6.7× |
| Anthropic | $0.118 | $0.821 | 7.0× |
| Zhipu | $0.108 | $0.590 | 5.4× |
| Alibaba | $0.166 | $0.777 | 4.7× |
| $0.181 | $1.197 | 6.6× | |
| Meta | $0.395 | $0.612 | 1.6× |
配套的工具调用次数也印证了这一点:埋深后普遍从个位数涨到 20 次上下(如某家从 5.8 → 18.4,约 3.2 倍)。这提醒一件事:比模型别只比 API 单价,要比「拿到一个可信结果」的总成本——真实世界里,这个数字可能是你在干净测试里估算的 5–7 倍。
最危险的分化:变难时,谁会说「我不确定」,谁会自信答错
这项审计里最该被记住的发现,是模型在变难时的行为分成了两派:
- 会踩刹车的:研究中标注为 Anthropic、OpenAI 的模型,在埋深条件下「强制声明不确定/弃答」的比例明显上升(其中一家弃答率从 0% 涨到约 55%);
- 硬着头皮答的:另外几家不太弃答,而是把「已提交的错误」顶上去(committed-error 上升 8–18 pp 不等)。
再叠加一个校准数据就更刺眼:全体 167 个错误答案里,120 个(72%)是以 80 分以上高置信度给出的,没有一个模型选择弃答。也就是说,「高置信 + 事实错误」不是意外,是常态。
论文还记录了一个 n=1 的生产事故(仅作个案、不用于估算比率):某模型在协助整理论文时,给出了准确的数据表格,却同时编造了三条关于论文结构的、没有依据的说法,直到人工核对源文件才发现。它事后的原话是:「表格是真的,编造是我干的。」
对做接入和路由的人,这一段的含义很硬:你不能把模型自报的置信度当放行信号。
LoopRouter 视角:把这套发现翻译成选型、路由与故障切换
这项研究没给出「该用谁」的答案(它自己也拒绝排名),但给了三条能直接落到系统里的规则:
- 选型看「埋深条件下的每答对成本」,不看干净跑分。榜单分数在这项审计里没能捕捉真实落差——clean 分数挤成一团,buried 才见真章。把候选模型放到你自己的、带噪声的真实语料上跑一遍,按「单位正确答案的总成本」排序,再决定谁进生产。这也是统一接入多模型的价值:能低成本地横向复测、随时替换。
- 按「会不会承认不确定」来设计路由与故障切换。会踩刹车、肯说「不确定」的模型,适合放在**能自动升级(转更强模型 / 转人工)**的链路首段——它的弃答就是最好的降级信号;而「自信答错」的模型若放在下游,会把污染悄悄传给后续环节,必须配外部校验。一个统一网关能把「某模型弃答/低置信」变成路由事件,自动切到备选或升级路径,而不是让错误一路盖章通过。
- 把校验做成独立的一层,而不是让模型自证。既然 72% 的错误都披着高置信度的外衣,唯一稳妥的做法是要求逐条证据回执(答案对应哪个文件、哪一段),并用一个独立的核验步骤去比对。这层开销要计入总账——但它是把「每答对成本」控制住的前提,否则你省下的单价会在错误的下游成本里加倍还回来。
落地一句话:干净跑分是选型里最贵的错觉。真正该进你决策表的是两个数字——真实(带噪声)条件下,每答对一题烧多少钱,以及它答错时会不会告诉你。前者决定成本治理,后者决定你敢不敢把它塞进自动化链路;而一个能统一接入、按置信度/弃答自动路由与故障切换的网关,是把这两件事管起来的地方。