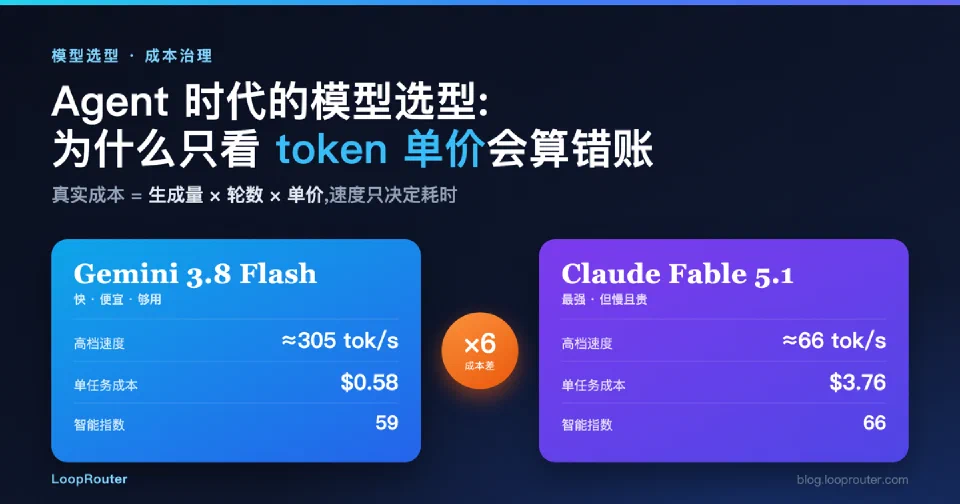
本文基于 InfoQ 中文对 Gemini 3.8 Flash 的公开报道整理,数据引自 Artificial Analysis 等第三方基准,并加入 LoopRouter 在模型接入与成本治理上的二次分析;原文见文末链接。文中型号与日期沿用来源设定,基准分数建议以你自己的任务集复测。
一句话结论:评估一个 Agent 模型,只看每百万 token 的单价已经不够了。Gemini 3.8 Flash 的输出单价没涨,但因为它「更努力地思考」——多生成 token、多调几轮工具——单任务成本反而涨了约 40%。真正决定账单的,是「生成多少 token × 执行多少轮 × 单价」,再叠加吞吐速度对端到端耗时的影响。选型和路由,都要盯这个复合指标,而不是单价那一栏。
单价没涨,账单为什么涨了 40%?
这是 Agent 时代最容易算错的一笔账。传统印象里,模型迭代要么涨价要么降价,单价是核心变量。但 Gemini 3.8 Flash 打破了这个直觉:
- 输出 token 单价没变(推广期每百万输入 0.75 美元、输出 3.75 美元,年底后翻倍);
- 单任务成本却从约 0.40 美元涨到 0.58 美元,约 +40%。
差额从哪来?来自模型「更努力」的行为方式。Google 没有把 Flash 做成缩小版的 Pro,而是让它在同一个任务上增加推理步骤、反复调用工具、跑更多轮次:
| 指标 | 变化 |
|---|---|
| 加权平均输出 token | 增长约 30%,达约 4.8 万个/任务 |
| 单任务成本 | 0.40 → 0.58 美元(约 +40%) |
| 加权生成耗时 | 2.2 → 2.5 分钟(约 +14%) |
| 输出 token 单价 | 不变 |
也就是说,成本的增量几乎全部来自「模型自己决定多做的事」,而不是供应商调价。对按量计费的生产系统,这意味着你无法只用「单价 × 预估 token」来做预算——因为 token 数本身是模型在运行时动态决定的。想把这类隐性 token 成本算清楚,可参考 AI API 计费是怎么算的 里的口径拆解。
Agent 模型的真实成本公式
把上面的现象抽象一下,Agent 模型的单任务开销大致是:
单任务成本 ≈ 单任务累计生成 token 数 × token 单价(累计 token 数 = 每轮 token × 执行轮数)
端到端耗时 ≈ 单任务累计生成 token 数 ÷ 吞吐速度(TPS)
单价只是其中一个乘数。另外三个变量——生成量、轮数、速度——才是不同模型之间拉开差距的地方。Gemini 3.8 Flash 的取舍很清楚:它多花了 token 和轮数(推高成本),但用极高的吞吐把耗时压住(高 TPS 抵消了额外 token 带来的时间)。
速度是它的杀手锏,智能水平只进第一梯队
把 Gemini 3.8 Flash 放进横向数据里,画像就清晰了:
| 模型 | 智能指数 | 高推理档速度(TPS) | 单任务成本 |
|---|---|---|---|
| Claude Fable 5.1 | 66(榜首) | 66 | 约 3.76 美元 |
| Claude Opus 5 | 63 | 56 | — |
| GLM-5.3 / Kimi K3 | 60 | — | — |
| Gemini 3.8 Flash | 59 | 约 305 | 约 0.58 美元 |
| GPT-5.6 Sol(xhigh) | 59 | — | — |
| GPT-5.6 Terra | 57 | — | 约 0.53 美元 |
| GPT-5.6 Luna | — | 126 | — |
| DeepSeek V4 Pro | — | 80 | — |
表中为跨来源拼合的公开数据,空缺表示原文未给出对应数字;不同档位(如 xhigh/medium)不可直接横比。
三个要点:
- 速度断层领先:约 305 TPS,较多数主流模型快 4–6 倍(接近 Claude Fable 5.1 的 5 倍、Opus 5 的 5 倍多;对更快的 GPT-5.6 Luna 126、Meta Muse Spark 1.2 154 也有约 2 倍优势)。对交互式、流式输出的场景,这是能被用户直接感知的体验差。
- 智能进第一梯队,但非榜首:59 分与 GPT-5.6 Sol、Grok 4.6 持平,落后 Claude Fable 5.1 共 7 分。它是「够强 + 极快 + 便宜」,不是「最强」。
- 同价位里性价比突出:0.58 美元在相近智能档里最便宜;GPT-5.6 Terra 虽然 0.53 美元更低,但智能分低 2 分。
在编码/Agent 类任务上它也不弱:DeepSWE v1.1 达 74%,与 Claude Opus 5 并列长程软件工程榜首;τ³-Banking 提高 12 个百分点到 45%。
别被跑分骗了:基准只回答了一半
原文有一句很值得贴到选型清单上的话:「基准测试只能回答一半。」
一个「更努力」的模型会生成更多 token、跑更多轮——跑分可能更好看,但你要额外验证:这些多出来的 token 是真的提高了任务成功率,还是只是用更长的过程制造了更昂贵的错误? 两者在账单上都表现为「成本上升」,但价值天差地别。
它的短板也很实在:
- 计算机操作提升有限:OSWorld-2.0 超过上一代 3.7 Flash,但与 Claude Opus 5 仍有明显差距;
- 不是全能榜首:只进第一梯队;
- 靠 Flash 而非 Pro 重回前沿:承诺的 Pro 档缺席,选型时要考虑产品线的稳定性。
落地动作:接入前,用你自己的任务集测「单位成本的任务成功率」,而不是只抄一个跑分。同一个任务跑 20 次,统计成功率 × 平均成本,才是可用于预算的数字。
这对企业的多模型接入意味着什么
单一模型永远只能占据「智能–速度–成本」三角的一个角。Gemini 3.8 Flash 占的是「快 + 便宜 + 够用」;Claude Fable 5.1 占的是「最强、但慢且贵约 6 倍」。指望一个模型通吃所有任务,要么为简单请求过度付费,要么在难任务上质量不足。
更稳的做法是用统一接入层做智能路由,把「模型选型」从一次性决策变成一条动态策略:
- 按任务分层路由:简单、高频、延迟敏感的请求(补全、分类、常规问答)走 Gemini 3.8 Flash 这类快而便宜的模型;高难、低频、失败代价高的任务(复杂推理、关键代码生成)走 Claude Fable 5.1 这类更强的模型。
- 按复合成本而非单价路由:路由权重要看「单位成功的成本」(单任务成本 ÷ 成功率),而不是单价那一栏——否则会被「单价低但爱多烧 token」的模型反噬。
- 按可用性做故障切换:任一模型限流或降级时,自动切到能力相近的备选,别让单点故障阻塞业务。
- 把速度也算进 SLA:305 TPS 与 56 TPS 是数量级的体验差,对流式交互场景,吞吐应当是路由的一等公民,而非事后考虑。
一句话:在 Agent 时代,「选一个最好的模型」是伪命题,「按任务把请求路由到对的模型、并按复合成本和可用性动态切换」才是可持续的接入策略。 这正是 LoopRouter 想解决的问题——统一 API 接入国内外主流模型,按价格、延迟、吞吐、可用性做智能路由与故障切换,让你既吃到 Gemini 3.8 Flash 这类模型的速度与成本红利,又在关键任务上守住质量底线。
原文出处:InfoQ 中文《“美国大豆包"Gemini 翻身:输出速度碾压同行、智能水平重回第一梯队》 · https://www.infoq.cn/article/M792kCZ4FIzk7YHe4WhT