本文基于 arXiv 论文《Beyond Outcomes: Dual-View Relational Learning for Efficient Agent Benchmarking》(DualViewEval)的公开内容整理与二次分析,加入 LoopRouter 的选型/路由视角;原文见文末链接。
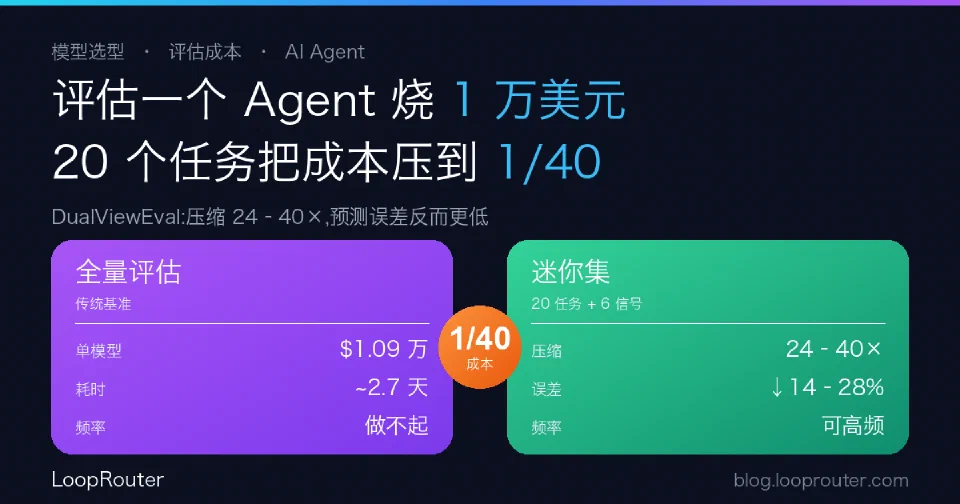
结论先说:评估一个 Agent 模型的成本,已经高到会拖累"选型"这件事本身。 论文给的参照数字是——在 APEX-Agents 基准上评估 Claude Opus 4.8 约花 1.09 万美元;评估 Gemini 3.5 Flash 即便按理想的十路并行,也要跑约 2.7 天。当你想在多个模型/供应商之间做选型对比,这个价签意味着"全量测一轮"是一件很难高频重复的事。DualViewEval 的解法是:用一个只有 20 个任务的迷你集,把评估成本压缩 24–40 倍,而预测出的模型排名和得分反而更准。
对做多模型接入和路由的团队,这不是一篇纯学术论文——它回答的是一个很现实的运营问题:当模型和价格每周都在变,你怎么用付得起的成本,持续判断"这类任务现在该路由给谁"?
为什么 Agent 评估贵到"测不起"
普通大模型基准是一问一答:给一道题,读一段回答,打个分,可以大规模并发。Agent 基准不一样——它要求长链路推理、反复调工具、和有状态的环境反复交互。一道题往往是几十步操作:读文件、改代码、跑测试、看报错、再改。每一步都要一次(或多次)模型推理,还要维护环境状态。
结果就是单位评估成本和耗时都高一个量级。论文给的两个具体参照很有代表性:
- 在 APEX-Agents 上评估 Claude Opus 4.8,约花 1.09 万美元;
- 评估 Gemini 3.5 Flash,即便假设十路并行的理想条件,也要跑约 2.7 天。
一个模型就这个价,而选型要横向比好几个。等你测完,前沿模型可能又更新了一版,供应商也可能又调了价——评估的速度追不上模型迭代的速度,这才是真正的痛点。
DualViewEval 怎么做到"少测还更准"
已有的基准压缩方法,大多只利用一种冗余:结果冗余——不同模型在很多题上的最终得分高度相关,所以不必每道都测。DualViewEval 的核心主张是,这漏掉了另一半信息:过程冗余。
它同时从"结果"和"过程"两个视角建模任务之间的关系,学出一个固定大小的迷你集(headline 结果用 20 个任务),再用这 20 道题去预测模型在全量基准上的得分。一句话:不是随机抽 20 道,而是挑出信息量最大、最能把模型区分开的 20 道。
六个"过程信号":看模型怎么干活,而不只看它对没对
“过程视角"具体看什么?论文识别出六个互补的过程信号,系统性地和最终表现相关:
| 过程信号 | 它捕捉什么 |
|---|---|
| 智能体步数(Agent steps) | 完成任务花了多少步,反映效率与绕路程度 |
| 工具调用失败率(Tool failed rate) | 调工具时报错/无效的比例,反映"手稳不稳” |
| 工具类别熵(Tool-category entropy) | 用了多少种不同工具,反映策略是否多样 |
| 验证类工具占比(Validation-tool rate) | 有没有主动去核验自己的结果 |
| 必要写操作是否执行(Required-write execution) | 该落盘/该改的东西有没有真的做 |
| 读—写—验证闭环(Read–write–validate closure) | “读取→修改→验证"这个闭环是否走完 |
这些信号描述的是模型解题的"手法”,而不只是最后一格的对错。好处是:在只看很少几道题时,过程信号能更早暴露模型之间的能力差异——两个模型可能都答对了,但一个是走了完整的读—写—验证闭环,另一个是碰运气蒙对的,过程信号能把这种差别显出来。
数据:压缩 24–40 倍,误差反而更低
论文在 5 个 Agent 基准上、对 5 种代表性压缩基线(Anchor Points、gp-IRT、TailoredBench、EssenceBench、SparseEval)做了对比,覆盖 BFCL(V4 多轮)、τ²-Bench、Terminal-Bench 2、SWE-bench Verified、APEX-Agents。关键结果:
- 压缩比:在 APEX-Agents 和 BFCL 上做到 24×–40× 压缩;
- 更准:预测全量得分的平均绝对误差(MAE)比最强对手低 14.5%–28.2%,相对 SparseEval 更是低 30.5%–45.1%;
- 排名更稳:在 SWE-bench Verified 上,排序一致性(Kendall’s τ)相对 EssenceBench 最多提升约 7.2%。
换句话说:用不到全量 1/24 的任务量,得到比其它压缩法更接近真值的模型排名。 这正是选型场景最需要的——你要的是"谁比谁强、强多少"的可靠排序,不是把每道题都测一遍。
LoopRouter 视角:把"评估成本"当成治理成本来算
这篇论文表面在讲学术评测,落到企业接入层,其实解决的是**“持续选型"的经济性**问题。对做多模型统一接入和按任务路由的团队,有三点可以直接拿去用:
选型是一个持续动作,不是一次性决策。 新模型上线、老模型降价、你的任务分布变化,都会改变"这类任务该路由给谁"的答案。如果每次重评都要上万美元、好几天,选型就会退化成"拍脑袋沿用旧结论”。迷你集式的评估让"重评"便宜到可以高频做——这本身就是一种成本治理能力。
过程信号,离线选型和在线路由是同一份指标。 论文用来选题的六个信号里,工具调用失败率和读—写—验证闭环是否完成,恰恰也是 Agent 在线运行时该盯的健康指标。同一套信号,离线用来判断"哪个模型更适合这类 Agent 任务",在线用来判断"当前这条链路是不是在反复失败、该不该触发故障切换或降级路由"。选型和路由用同一种语言,决策才连得起来。
别把快筛当终检。 迷你集擅长的是"低成本、高频地估算模型排名",适合日常选型、回归监控、快速淘汰明显不合适的候选;但生产前的深度验证、边界 case、安全合规,仍要走更完整的评估。合理的用法是:用 20 个任务的迷你集做快筛,把候选从"全市场"收敛到"两三个",再对这两三个做重度验证——把最贵的那部分评估预算,花在真正接近上线的模型上。
一句话落地:评估成本本身,就是多模型治理成本的一部分。 谁能用更低的代价、更高的频率把"这类任务现在该给谁"这个问题重新算清楚,谁的路由决策就更贴近当下,而不是停在三个月前的旧结论上。
原文:Beyond Outcomes: Dual-View Relational Learning for Efficient Agent Benchmarking (arXiv:2609.18909)。本文为基于公开信息的整理与二次分析,数据以原论文为准。