本文基于 Latent Space(AINews)对 AEF-1 标准的报道整理与二次分析,加入 LoopRouter 在模型选型与评测信任上的视角;原文见文末链接。机构名称与措辞沿用来源设定,具体条款请以官方文本为准。
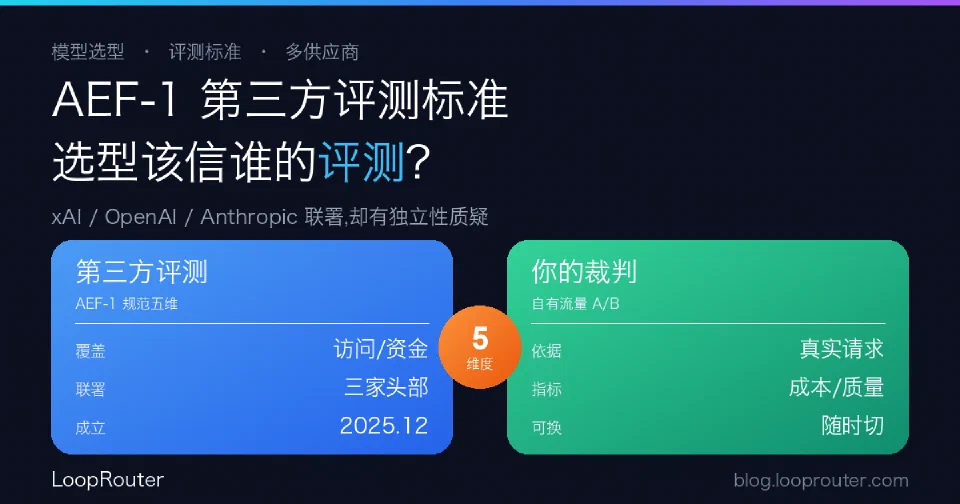
一句话结论:AI Evaluator Forum(2025 年 12 月成立)发布了 AEF-1——第三方独立评测的基线标准,规范访问权限、利益冲突、资金关系、回避、透明度五件事,并由 xAI、OpenAI、Anthropic 联署。但几乎同时,就有人质疑评测机构与实验室之间的资金牵连。对做选型的企业,真正该记住的是:第三方评测正在变得更可信,但你依然不能把选型外包给任何单一榜单——最终裁判应该是你自己的业务流量。
AEF-1 规范了什么
AEF-1 不是又一个「谁分高」的排行榜,而是一套评测方法与治理的基线——它管的是「评测这件事本身该怎么做才算独立可信」。
| 项目 | 内容 |
|---|---|
| 发布方 | AI Evaluator Forum(AEF) |
| 成立时间 | 2025 年 12 月 |
| 标准定位 | 第三方独立评测的基线(baseline) |
| 覆盖维度 | 访问权限、利益冲突、资金关系、回避、透明度 |
| 联署方 | xAI、OpenAI、Anthropic |
| 关联提案 | Dario Amodei 的 Embedded Evaluators(给 METR 等评测方「类员工」访问权) |
关联的 Embedded Evaluators 提案很有画面感:Anthropic 承诺给评测机构办公室工位、门禁卡、公司笔记本,以及与内部风险评估团队大致相当的工具和权限——目的是让外部评测能看到足够深的东西。
为什么「评测独立性」是个真问题
标准出台的同一时间,质疑声也来了。有评论者(Kevin Bass)公开发帖,指控部分 AI 安全/评测生态与 Anthropic 存在资金牵连,直指评测的独立性。
这不是抬杠,而是结构性张力:
- 被评测方深度参与规则:AEF 成员被描述为「大概率会被这些大厂招募、用于自我监管的头部第三方审计方」。当被评测者也在定义评测规则,独立性天然要打折。
- 给了访问权,也就给了影响力:「类员工」级别的深度访问能让评测更懂模型,但也让评测方与实验室的关系更紧、边界更模糊。
- 联署 ≠ 中立:三家头部一起联署,说明标准有分量,却也意味着规则很大程度由供给侧塑造。
结论不是「第三方评测没用」,而是:它是缩小范围的工具,不是替你拍板的法官。
榜单可信 ≠ 你能照抄:适用边界在哪
哪怕 AEF-1 把独立性做到位,第三方评测对企业选型仍有天生的边界:
- 评测任务≠你的任务:通用基准衡量的是通用能力,和你真实业务(你的数据分布、你的提示词、你的容错要求)未必对齐。榜单第一,不等于在你场景里第一。
- 静态分数≠线上表现:延迟、限流、稳定性、长期价格——这些决定生产可用性的因素,榜单通常不覆盖。
- 一次评测≠长期有效:模型在迭代、供应商在调价改额度,今天的评测结论有保鲜期。
LoopRouter 视角:让真实流量做裁判,而不是照抄榜单
评测标准化是行业的进步,但它无法替企业回答「在我的业务里,该用哪个模型」。这道题的稳妥解法,恰恰是把选型从「信一次榜单」变成「持续用真实流量验证」:
- 用统一接入层同时接多家模型:选型阶段不必二选一,把候选模型都接进来,用统一 API 调用,消除逐个对接的成本。
- 在生产流量上做 A/B 路由:让同一批真实请求分流到不同模型,按你关心的指标(正确率、成本、延迟、稳定性)比,而不是按第三方基准比。
- 把评测当输入、把路由当裁决:第三方评测(包括更规范的 AEF-1 结果)用来圈定候选,真正的取舍交给线上数据;模型或供应商一旦掉队,按权重自动切走。
- 保留随时换的能力:评测会有立场、模型会迭代、价格会变——唯一不变的应对是「换得动、换得快」。
一句话:第三方评测越来越规范是好事,但选型的最终裁判权,不该外包给任何一张榜单。 这正是 LoopRouter 想解决的问题——用统一 API 接入国内外主流模型,把多供应商路由、A/B 对比与故障切换收敛到网关层,让「谁更适合我的业务」由你自己的流量说了算,而不是由别人的评测替你决定。
原文出处:Latent Space (AINews)《AEF-1 standard emerges for Third Party Evaluators, as Xai, OpenAI, and Anthropic all cosign》 · https://www.latent.space/p/ainews-aef-1-standard-emerges-for